हर server का अलग web UI
हर server सिर्फ अपने runs दिखाता है। पाँच servers पर पिछली रात की failures देखने के लिए पाँच web UI खोलने पड़ते हैं।
Dagu Cloud
हर self-hosted Dagu server को Dagu Cloud से connect करें। उनकी health और runs एक console में देखें, team को वहीं alert करें जहाँ वह काम करती है, हर server में अलग से sign in किए बिना runs को retry, stop और approve करें, और ChatGPT या Claude को एक MCP endpoint से उन्हें operate करने दें। Workflows सिर्फ आपके servers पर ही चलते रहते हैं, जो खुद बाहर की ओर connect करते हैं; कोई inbound port नहीं खुलता।
एक server के लिए free। Team और Pro हर licensed server को cover करते हैं और runs पर actions, MCP और आपकी team जोड़ते हैं। Monitoring के लिए Dagu v2.19.1 या उसके बाद का version ज़रूरी है (free plan पर v2.19.2); runs पर actions और MCP के लिए v2.22 या उसके बाद का।
आपके servers
Workflows यहाँ चलते हैं
कुछ टूटने पर email, chat, PagerDuty या webhook से alert, और ठीक होने पर फिर से
हर Dagu server अपने आप में पूरा है, अपने scheduler, run history और web UI के साथ। कई servers होने का मतलब जाँचने की भी कई जगहें है, और किसी run को संभालना हो तो sign in करने की भी कई जगहें।
हर server सिर्फ अपने runs दिखाता है। पाँच servers पर पिछली रात की failures देखने के लिए पाँच web UI खोलने पड़ते हैं।
कोई भी चीज़ सभी servers की failures को एक जगह इकट्ठा नहीं करती, इसलिए पूरी तस्वीर किसी को नहीं दिखती।
रुका हुआ scheduler या चुप हो गया server कोई error नहीं देता। Scheduled workflows बस चलना बंद कर देते हैं, जब तक किसी का ध्यान न जाए।
Failure emails के लिए हर server पर mail और notification settings चाहिए, जिन्हें हाथ से एक जैसा रखना पड़ता है।
किसी failed run को retry करने या wait कर रहे step को approve करने के लिए सही server ढूँढना, उसका web UI खोलना और वहाँ sign in करना पड़ता है।
Firewall के पीछे के server पर ChatGPT या Claude से काम करवाने के लिए port खोलना पड़ता है या API key देनी पड़ती है।
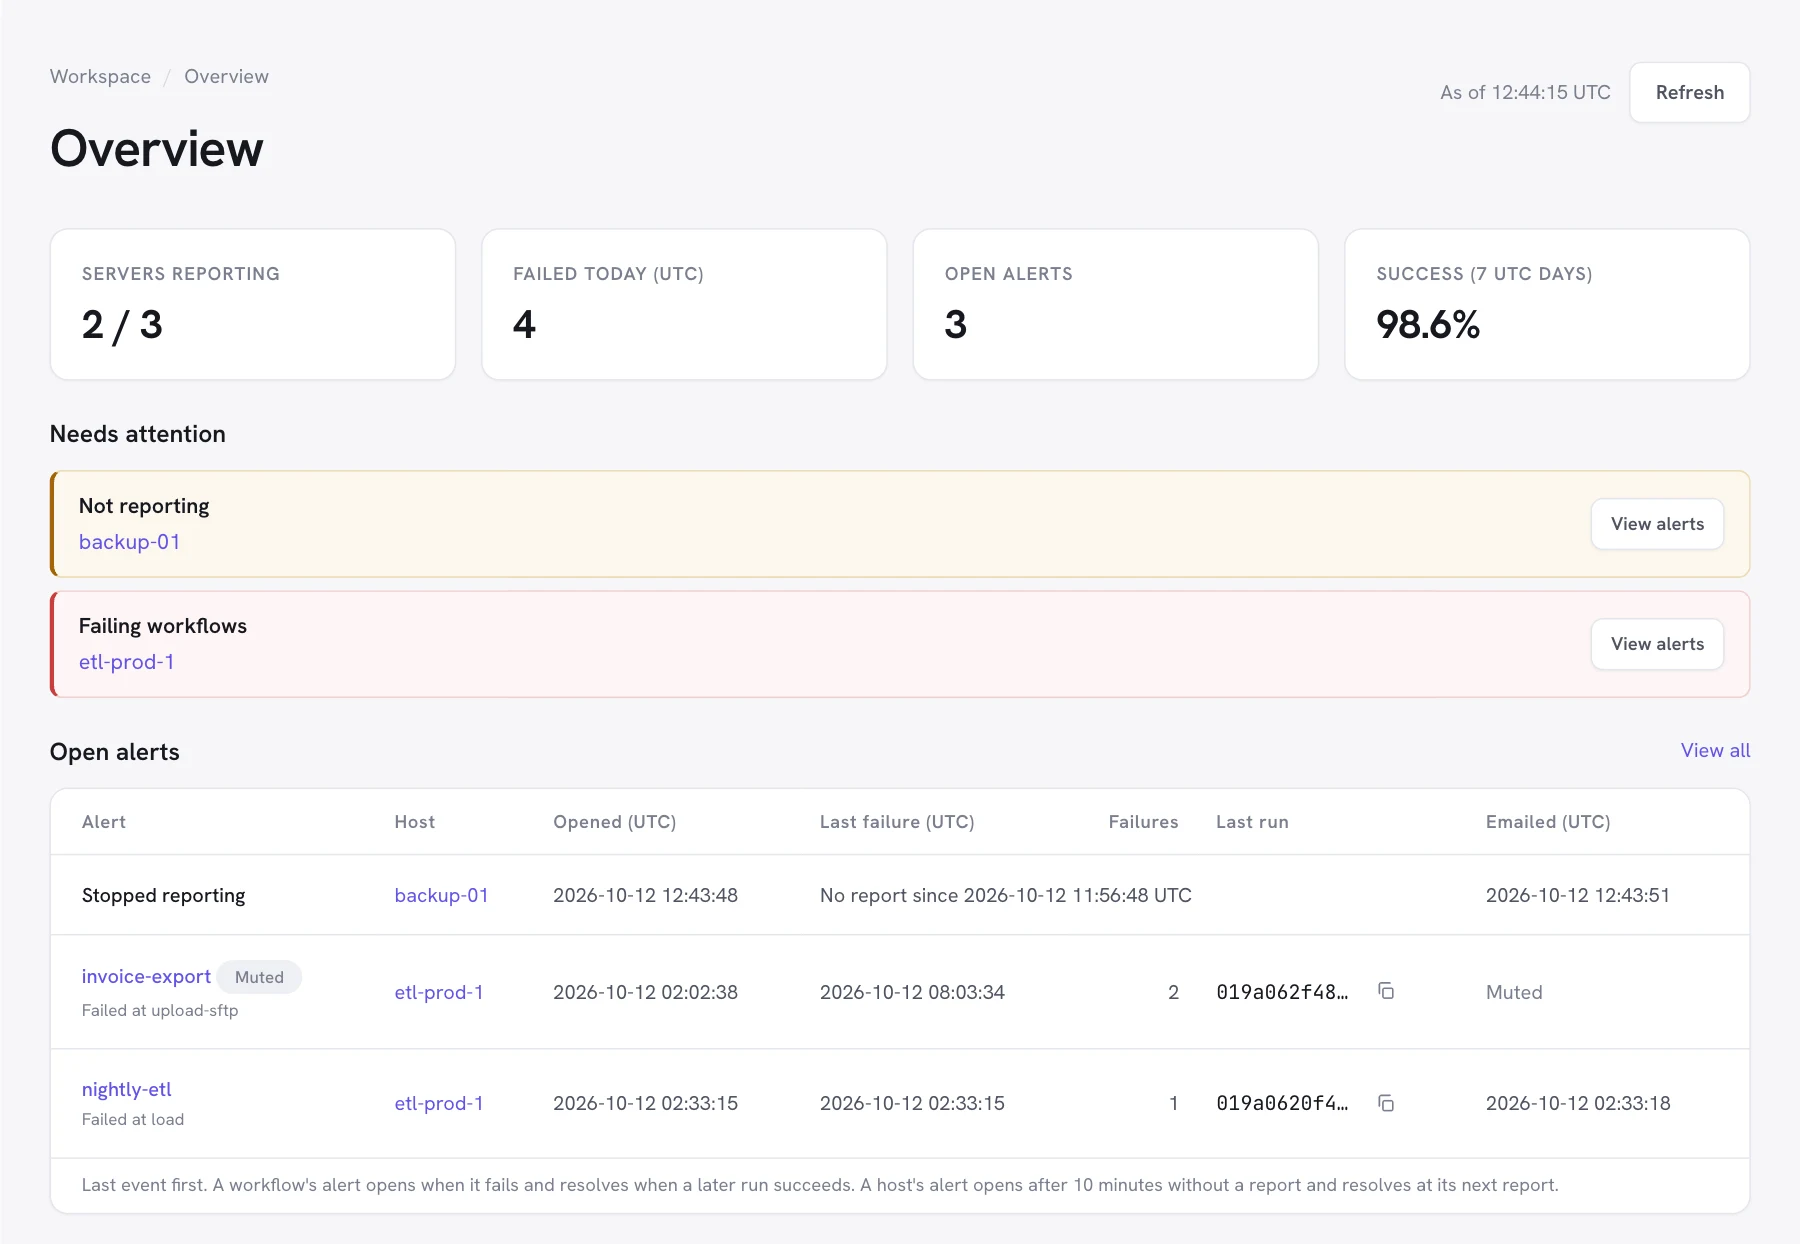
Dagu console के Monitoring section में Overview, Servers, Runs, Alerts, Notifications और Insights pages हैं, साथ ही हर server, हर workflow और हर alert का अपना page। Workspace का हर member इन्हें देख सकता है।
Report भेज रहे servers, आज की failures (UTC), चल रहे runs, और पिछले 7 UTC दिनों का success rate। Needs attention में वे चीज़ें दिखती हैं जो किसी व्यक्ति का इंतज़ार कर रही हैं, खुले alerts और आज की failures, हर row में उसके action के साथ।
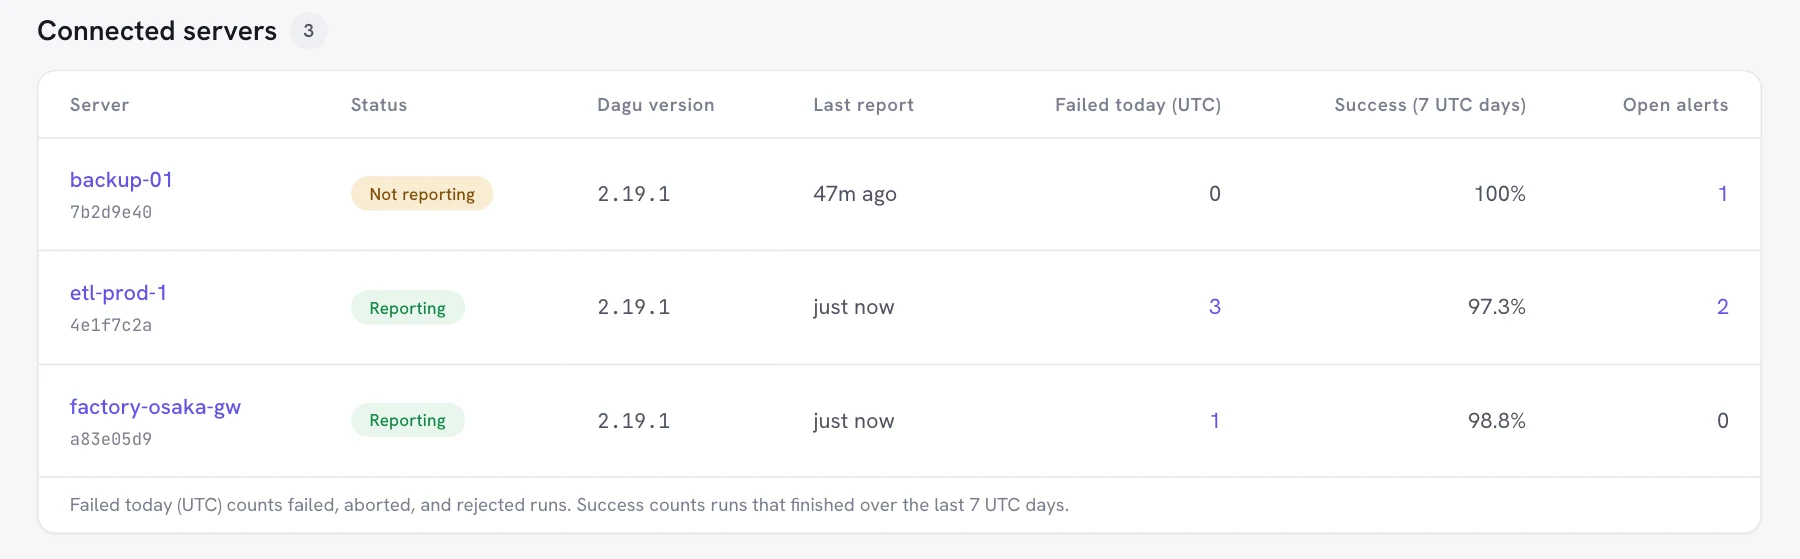
हर connected server, उसके status, Dagu version, आखिरी report, आज की failures (UTC), 7 UTC दिनों के success rate और खुले alerts के साथ।
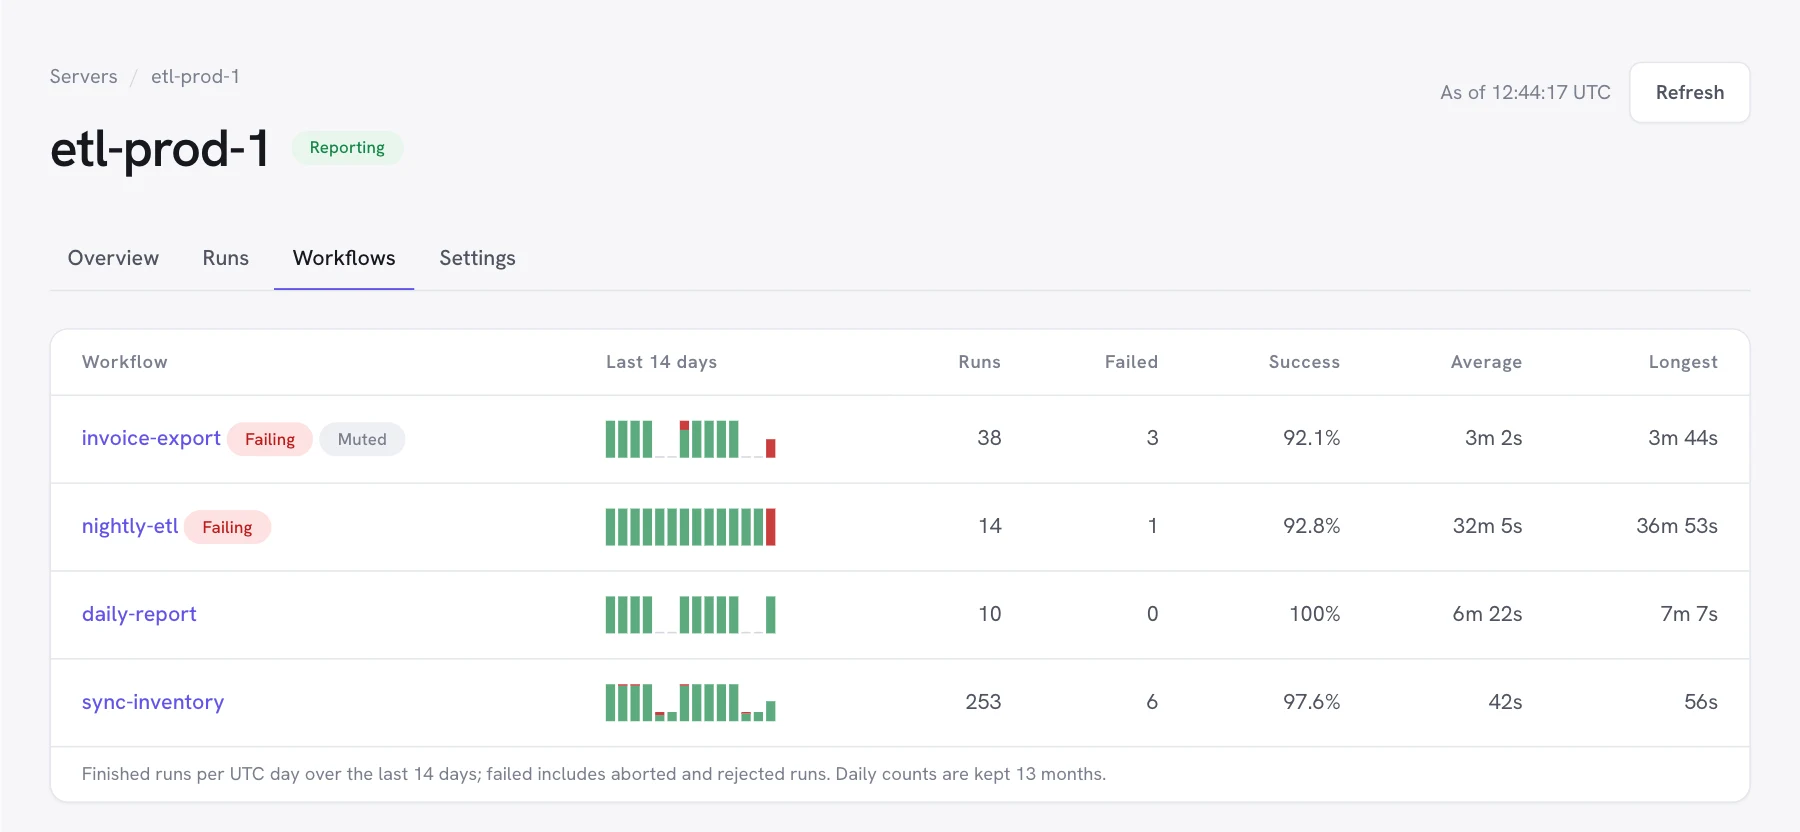
हर server का एक page। Overview उसकी health (Dagu version, OS और architecture, process शुरू होने का समय, आखिरी report, आखिरी check-in), आखिरी report की services, खुले alerts और हाल की failures दिखाता है। Runs उसके runs की सूची देता है। Workflows हर workflow के finished runs को 14 दिनों तक हर UTC दिन के हिसाब से दिखाता है, साथ में runs, failures, success rate, और औसत व सबसे लंबी duration।
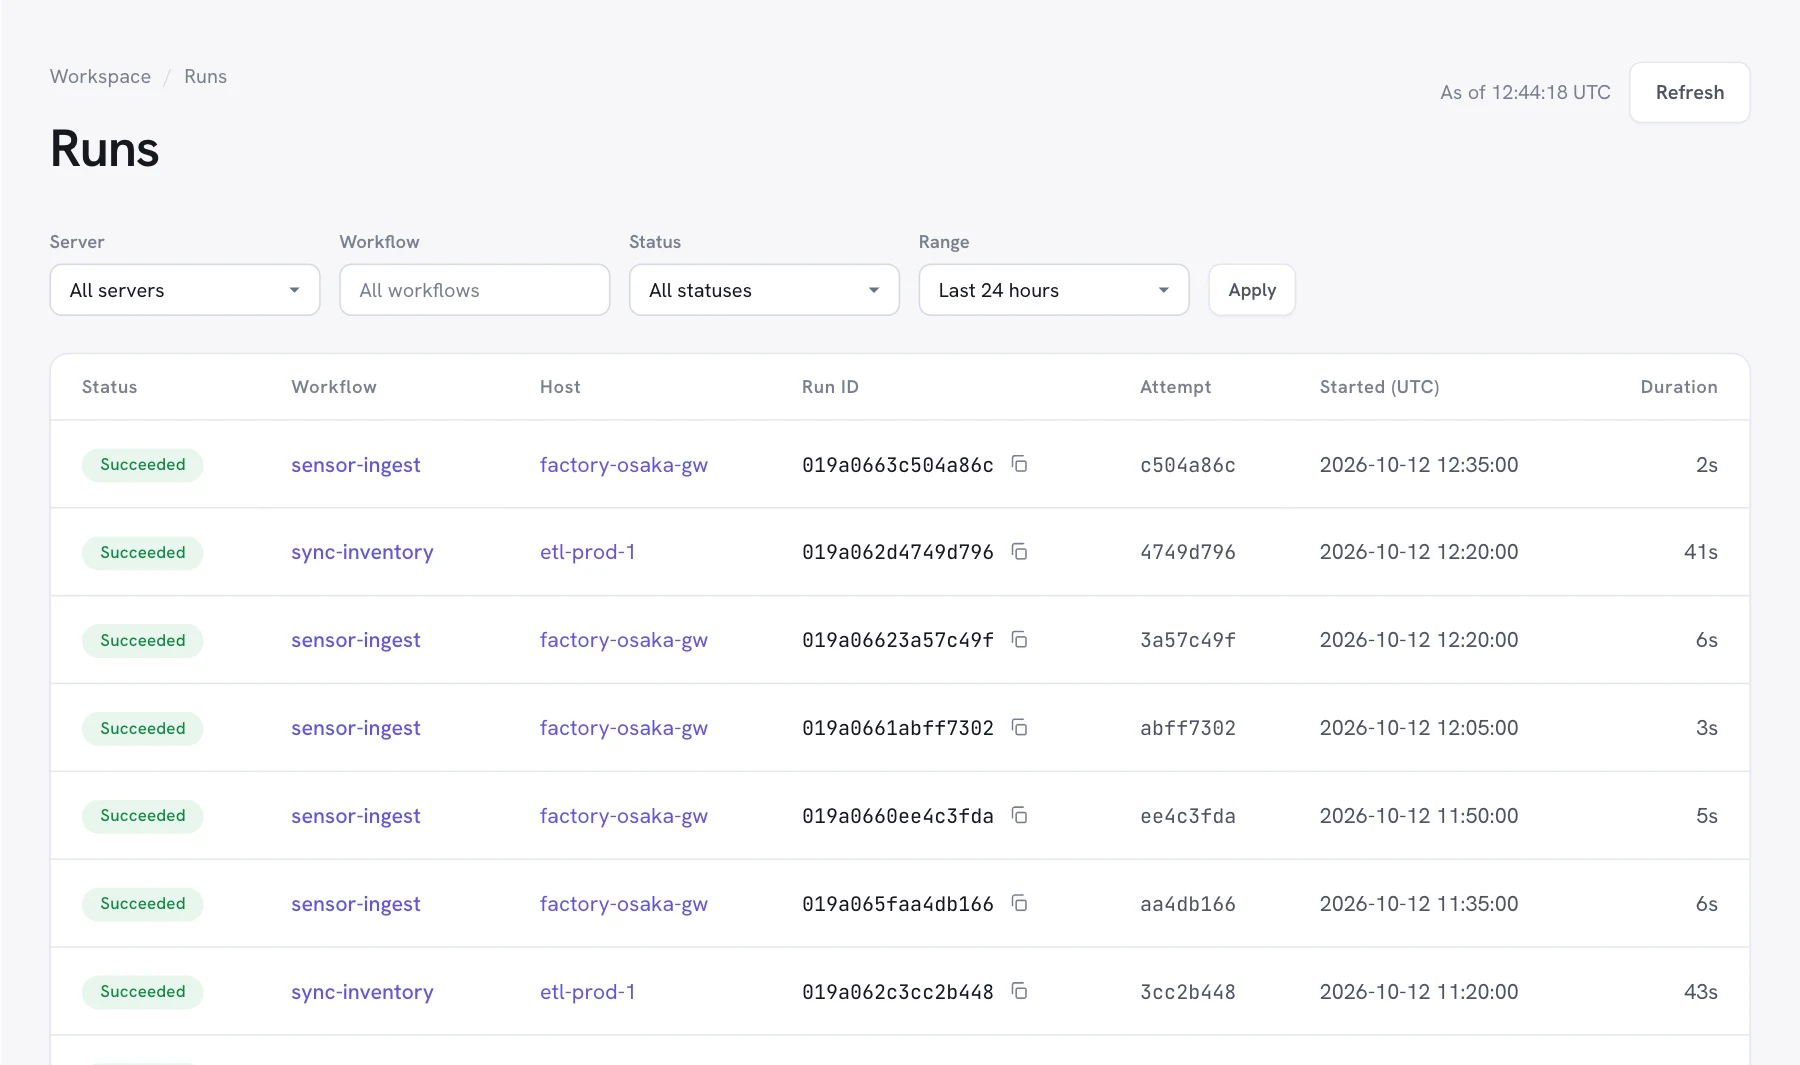
चल रहे runs पहले आते हैं, फिर finished runs, सबसे नए पहले। हर run का उसके attempts तक एक permalink होता है।
Server, workflow, status (failed, succeeded, running, waiting या queued) और range से filter करें: पिछला घंटा, 24 घंटे, 7 दिन, 14 दिन या, Team और Pro पर, 30 दिन।
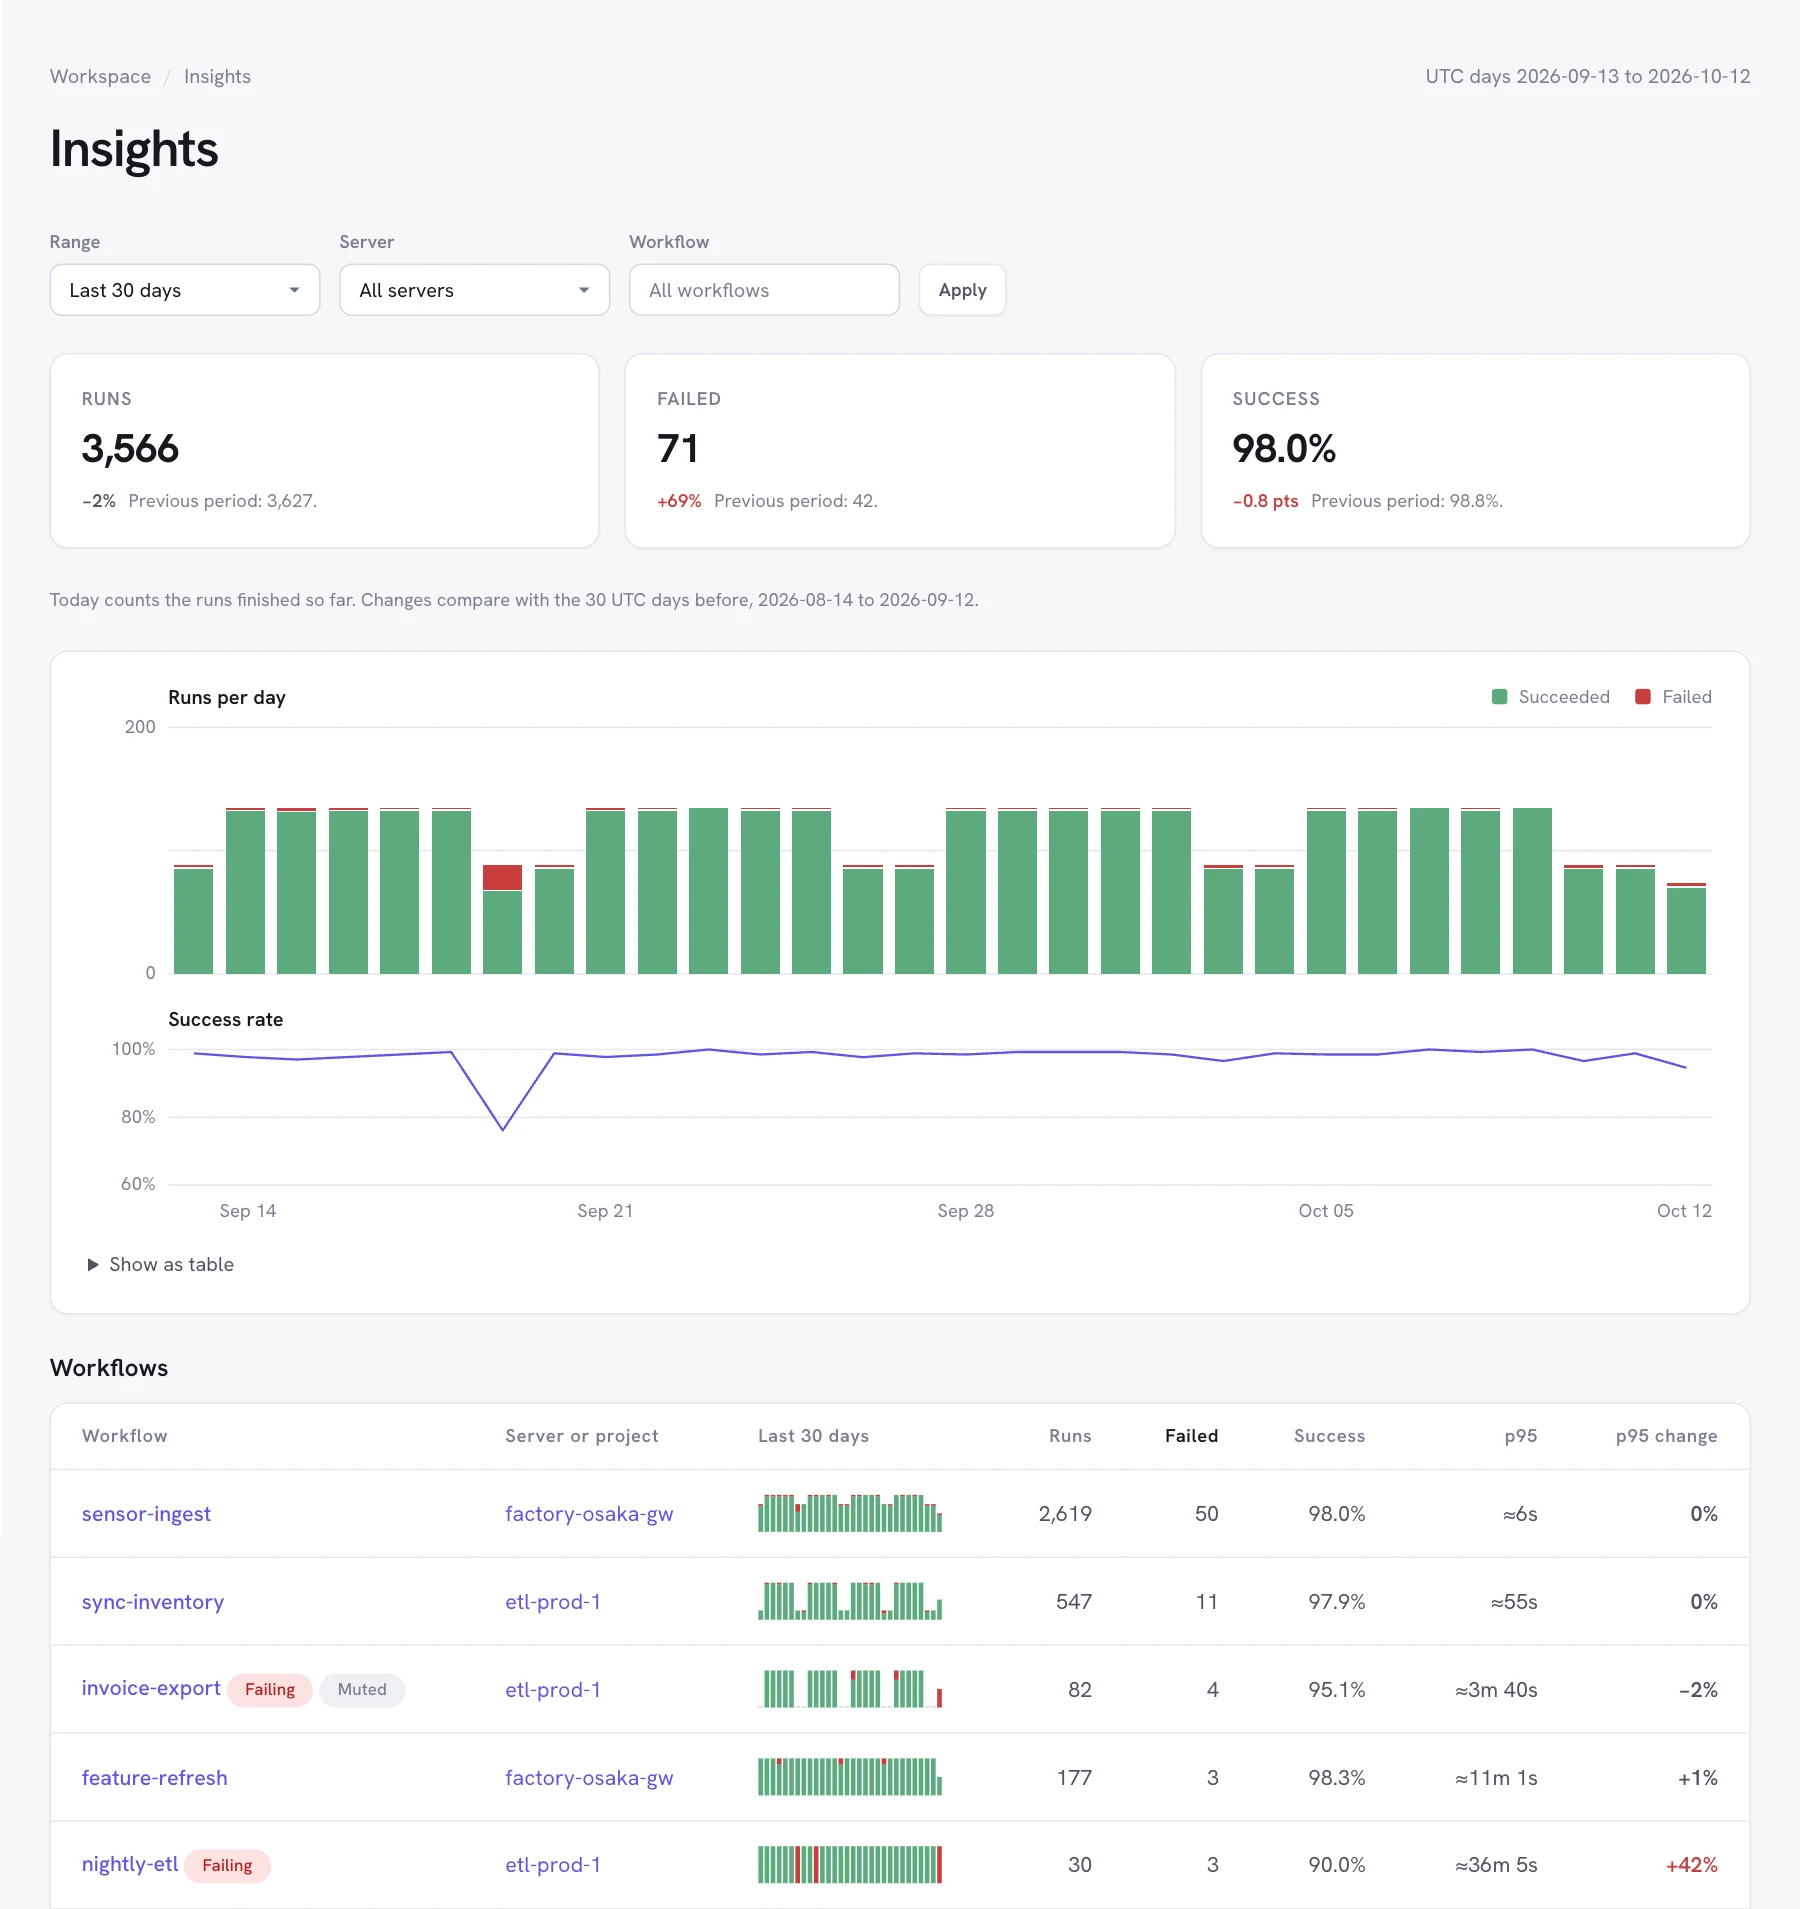
पिछली अवधि की तुलना में runs, failures और success rate, हर दिन के runs, और हर workflow की p95 duration व उसमें आया बदलाव। आज के runs खत्म होते ही गिने जाते हैं।
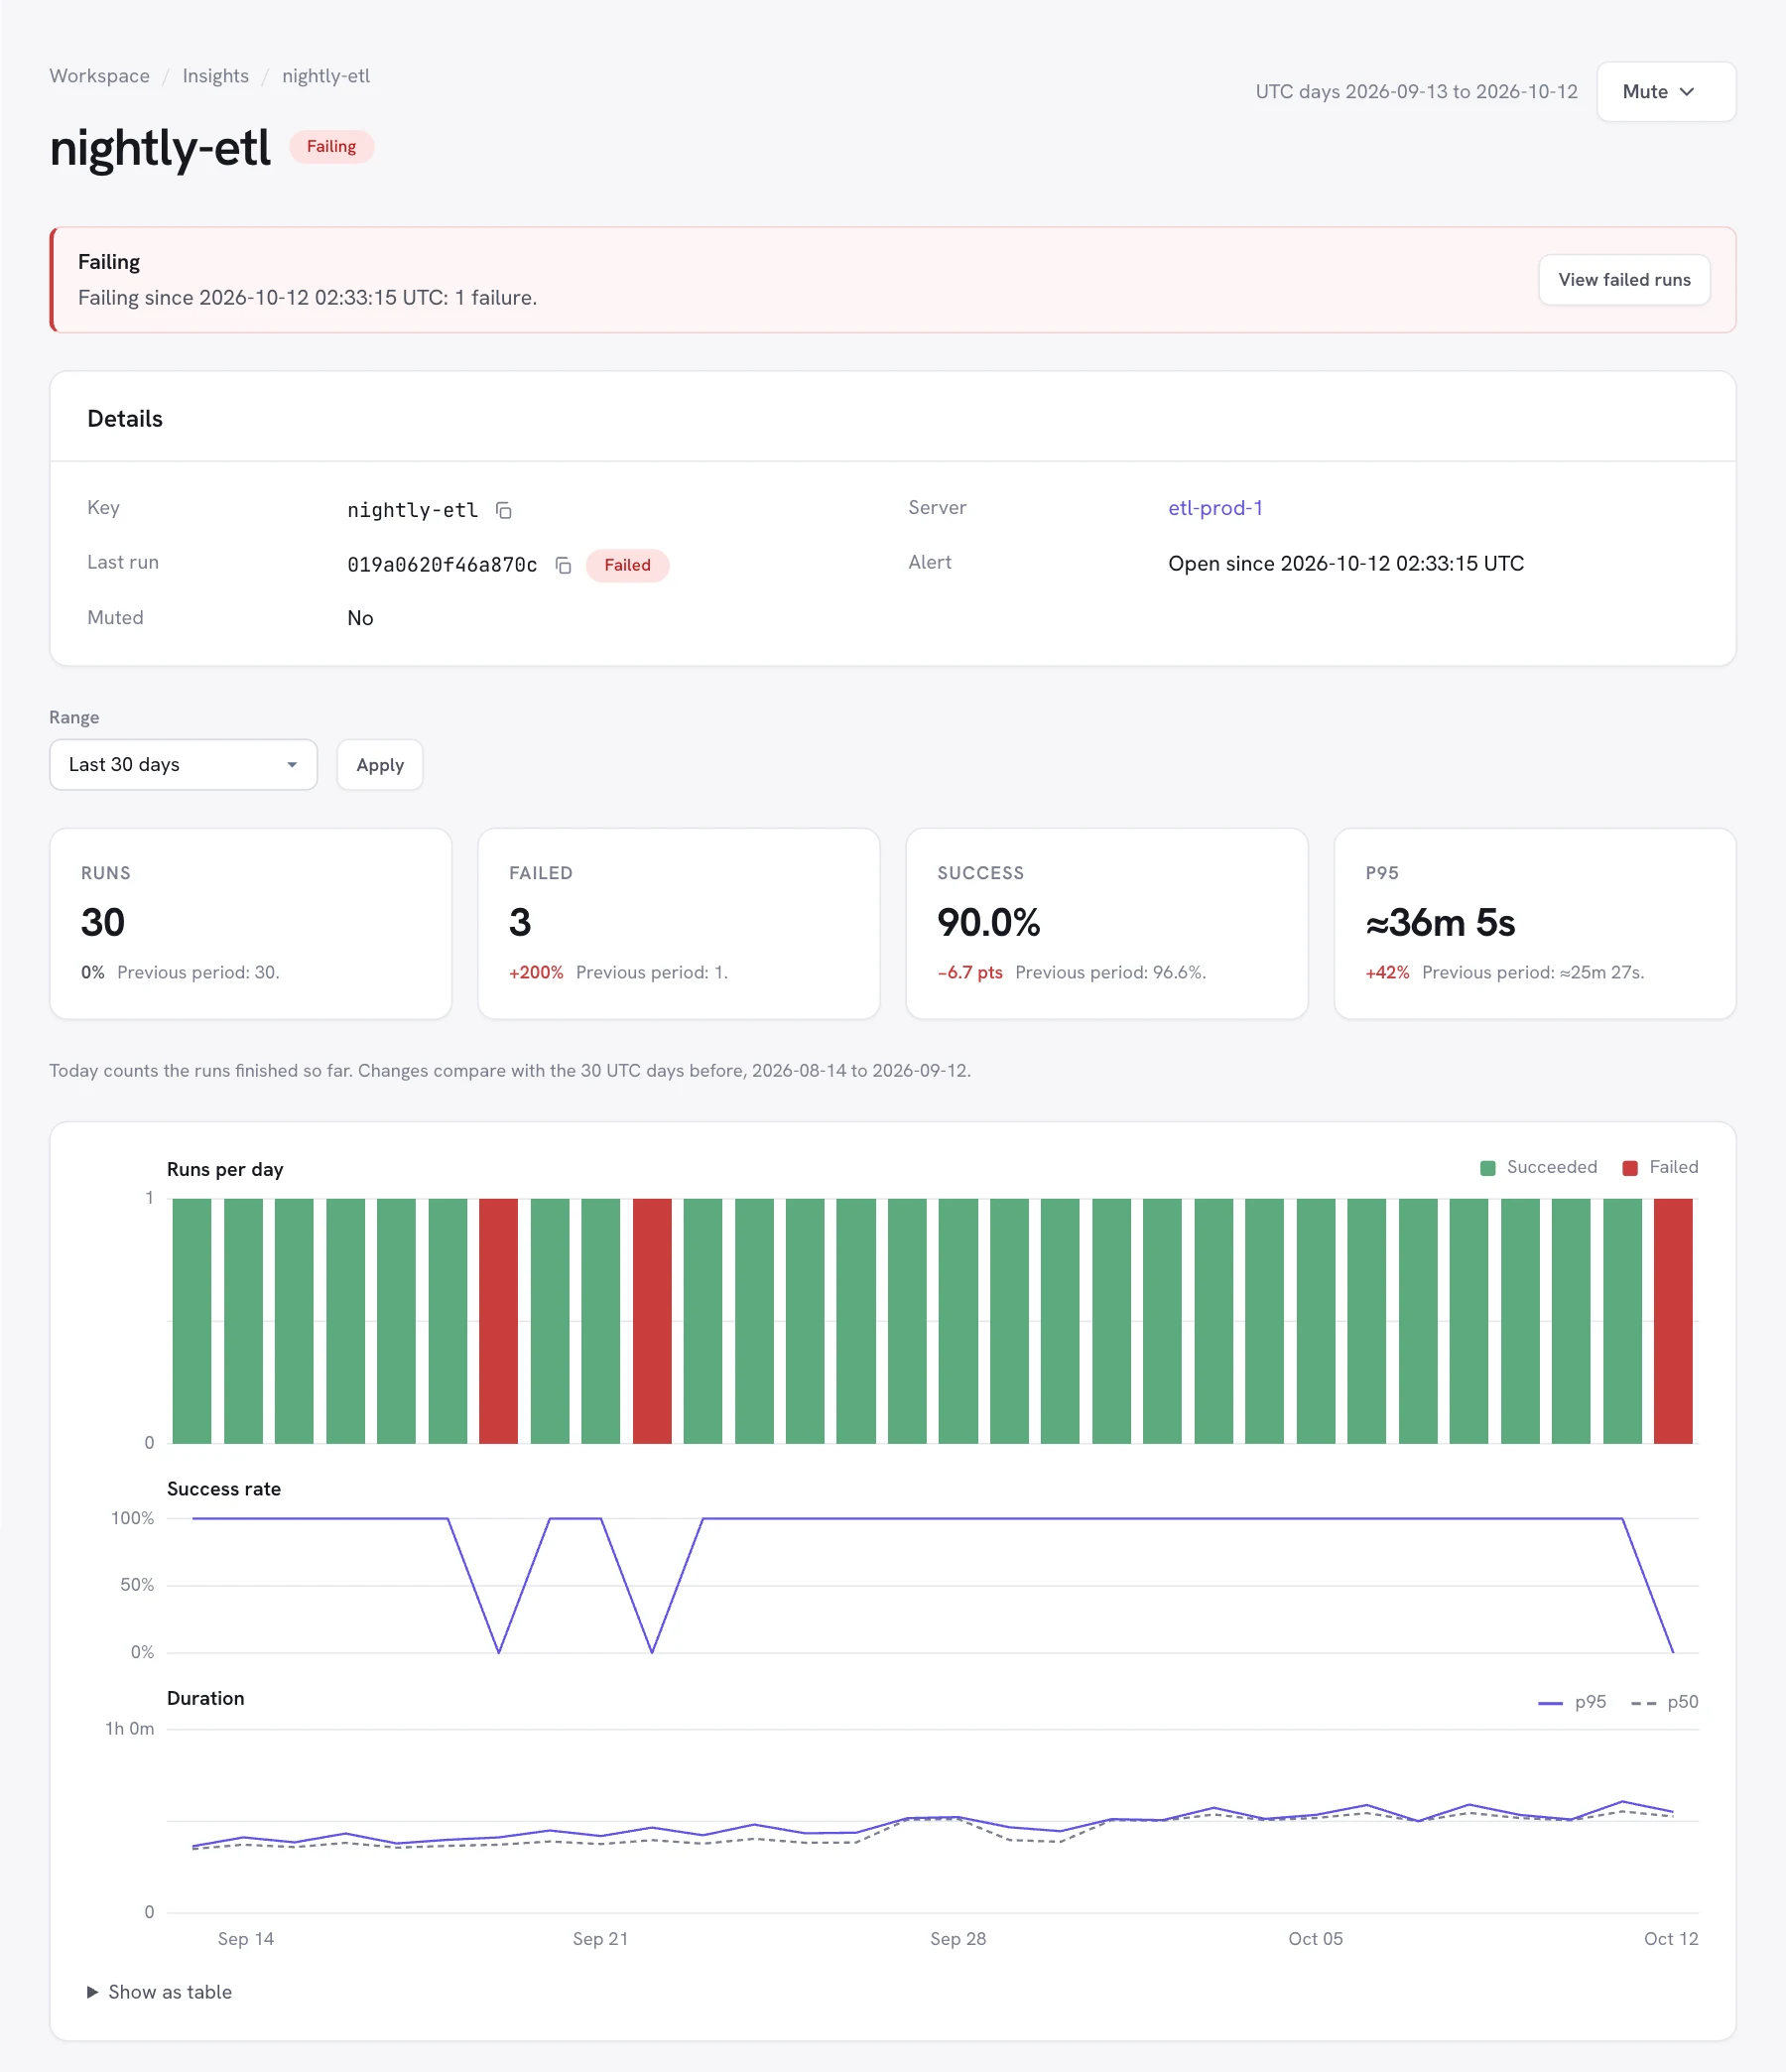
हर workflow का एक page, जिसमें उसका खुला alert, हर दिन के runs, success rate, और 7, 30 या 90 दिनों की p50 और p95 duration है, साथ में उसके हाल के runs और वे steps जिन पर वह fail हुआ। Owners उसे यहीं से mute कर सकते हैं।
Dagu Cloud हर server तक उसी connection से पहुँचता है जो server खुद खोलता है, इसलिए members और MCP clients बिना inbound port, VPN या API key के runs पर action ले सकते हैं।
Failed step का log पढ़ें, run को retry या stop करें, और किसी व्यक्ति का इंतज़ार कर रहे step को approve या reject करें, सीधे Overview, run या उसके alert से।
ChatGPT, Claude या कोई दूसरा MCP client एक बार connect करें। यह workspace के servers पर runs और logs पढ़ता है, workflows start और retry करता है, और DAGs edit करता है, उतना ही जितना हर member का role अनुमति देता है।
हर server का administrator remote access चालू करता है और सबसे ऊँचा allowed role तय करता है। हर call सिर्फ उसी request के लिए signed होती है और Dagu Cloud तथा server के अपने audit log, दोनों में दर्ज होती है।
Team और Pro पर, या trial में। Dagu v2.22 या उसके बाद का version ज़रूरी है।
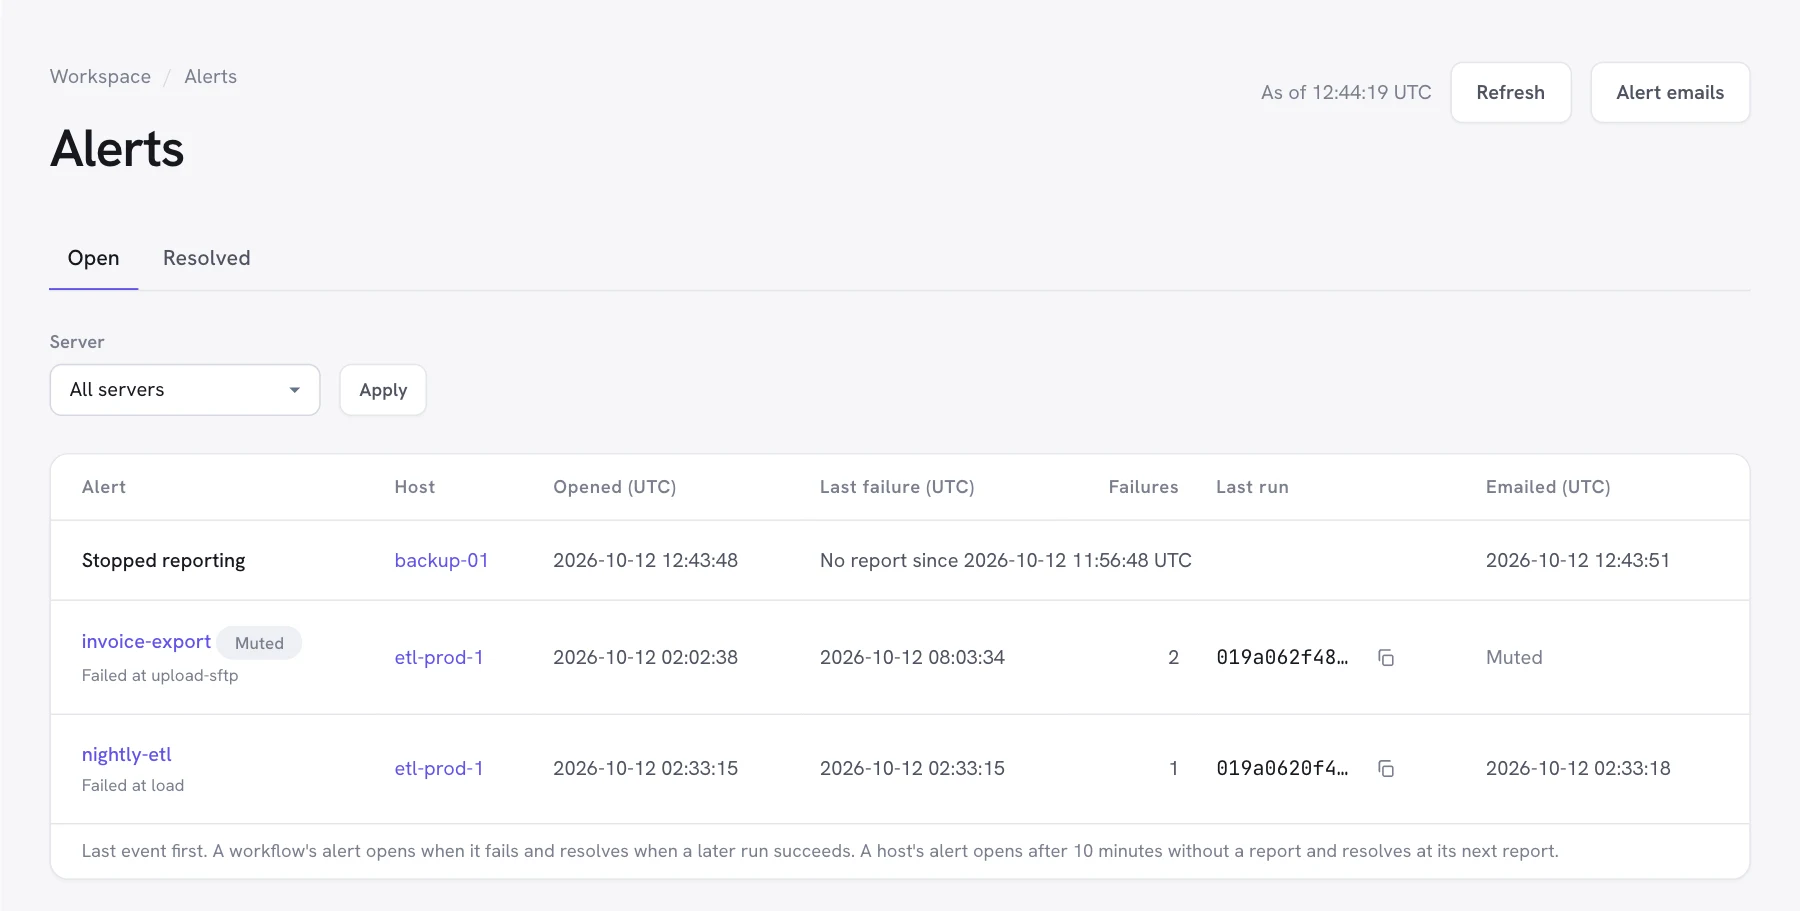
Remote access कैसे काम करता हैएक alert एक workflow या एक server का होता है। यह एक बार खुलता है, आगे जो होता है उसे गिनता है, और problem खत्म होते ही अपने आप resolve हो जाता है।
Failed run workflow का alert खोलता है। बाद की failures बिना नए message के उसकी गिनती बढ़ाती हैं, और अगला सफल run उसे resolve कर देता है।
10 मिनट तक कोई report नहीं, या free monitoring पर 25 मिनट, तो server का alert खुलता है, ताकि down host या रुका हुआ process नज़र में आए। उसकी अगली report उसे resolve कर देती है।
जो run अपने workflow के usual time के दोगुने और कम से कम 10 मिनट और के बाद भी चल रहा हो, वह alert खोलता है, इससे पहले कि कोई late report पर हैरान हो। Run खत्म होने पर यह resolve हो जाता है।
Workflow alerts के लिए Health and run status level चाहिए। Emails no-reply@dagu.sh से आते हैं।
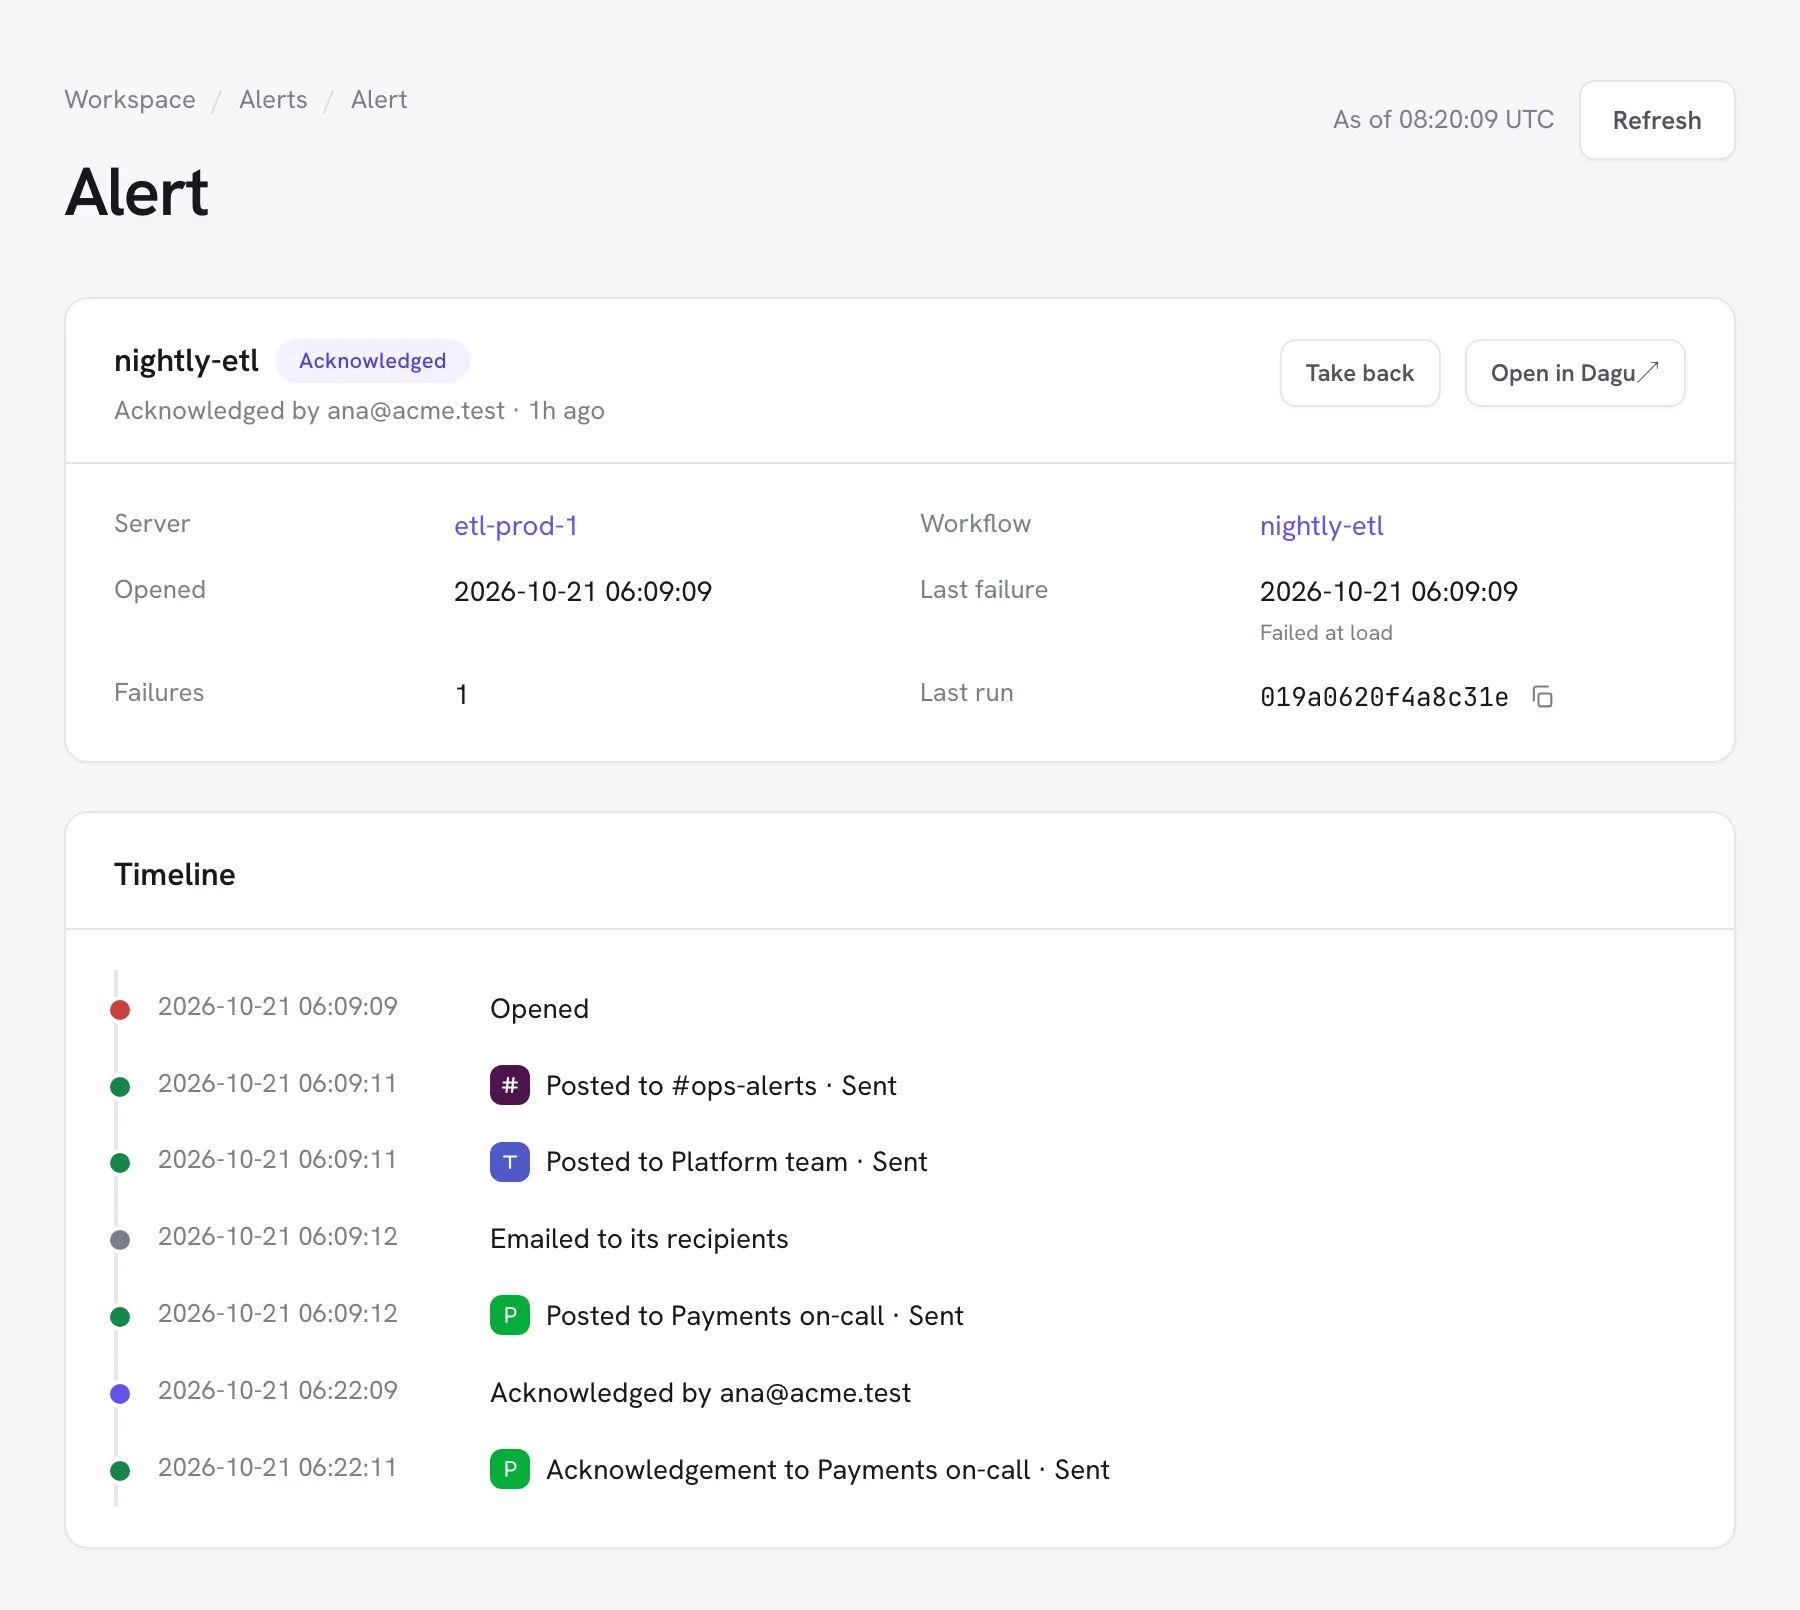
Alert emails owners और admins को जाते हैं, और उन members व verified outside addresses को जिन्हें आप जोड़ते हैं, हर एक में one-click unsubscribe के साथ। Team और Pro पर alerts 10 destinations तक भी जाते हैं: Slack, Microsoft Teams, Google Chat, Discord, PagerDuty और signed webhooks।
Destination जोड़ने पर एक test भेजा जाता है, और हर destination हर post और उसके answer का log रखता है। Failed post को backoff के साथ एक दिन तक फिर से भेजा जाता है, और जो destination लगातार तीन बार alerts refuse करे, वह रुक जाता है और यह बताता है।
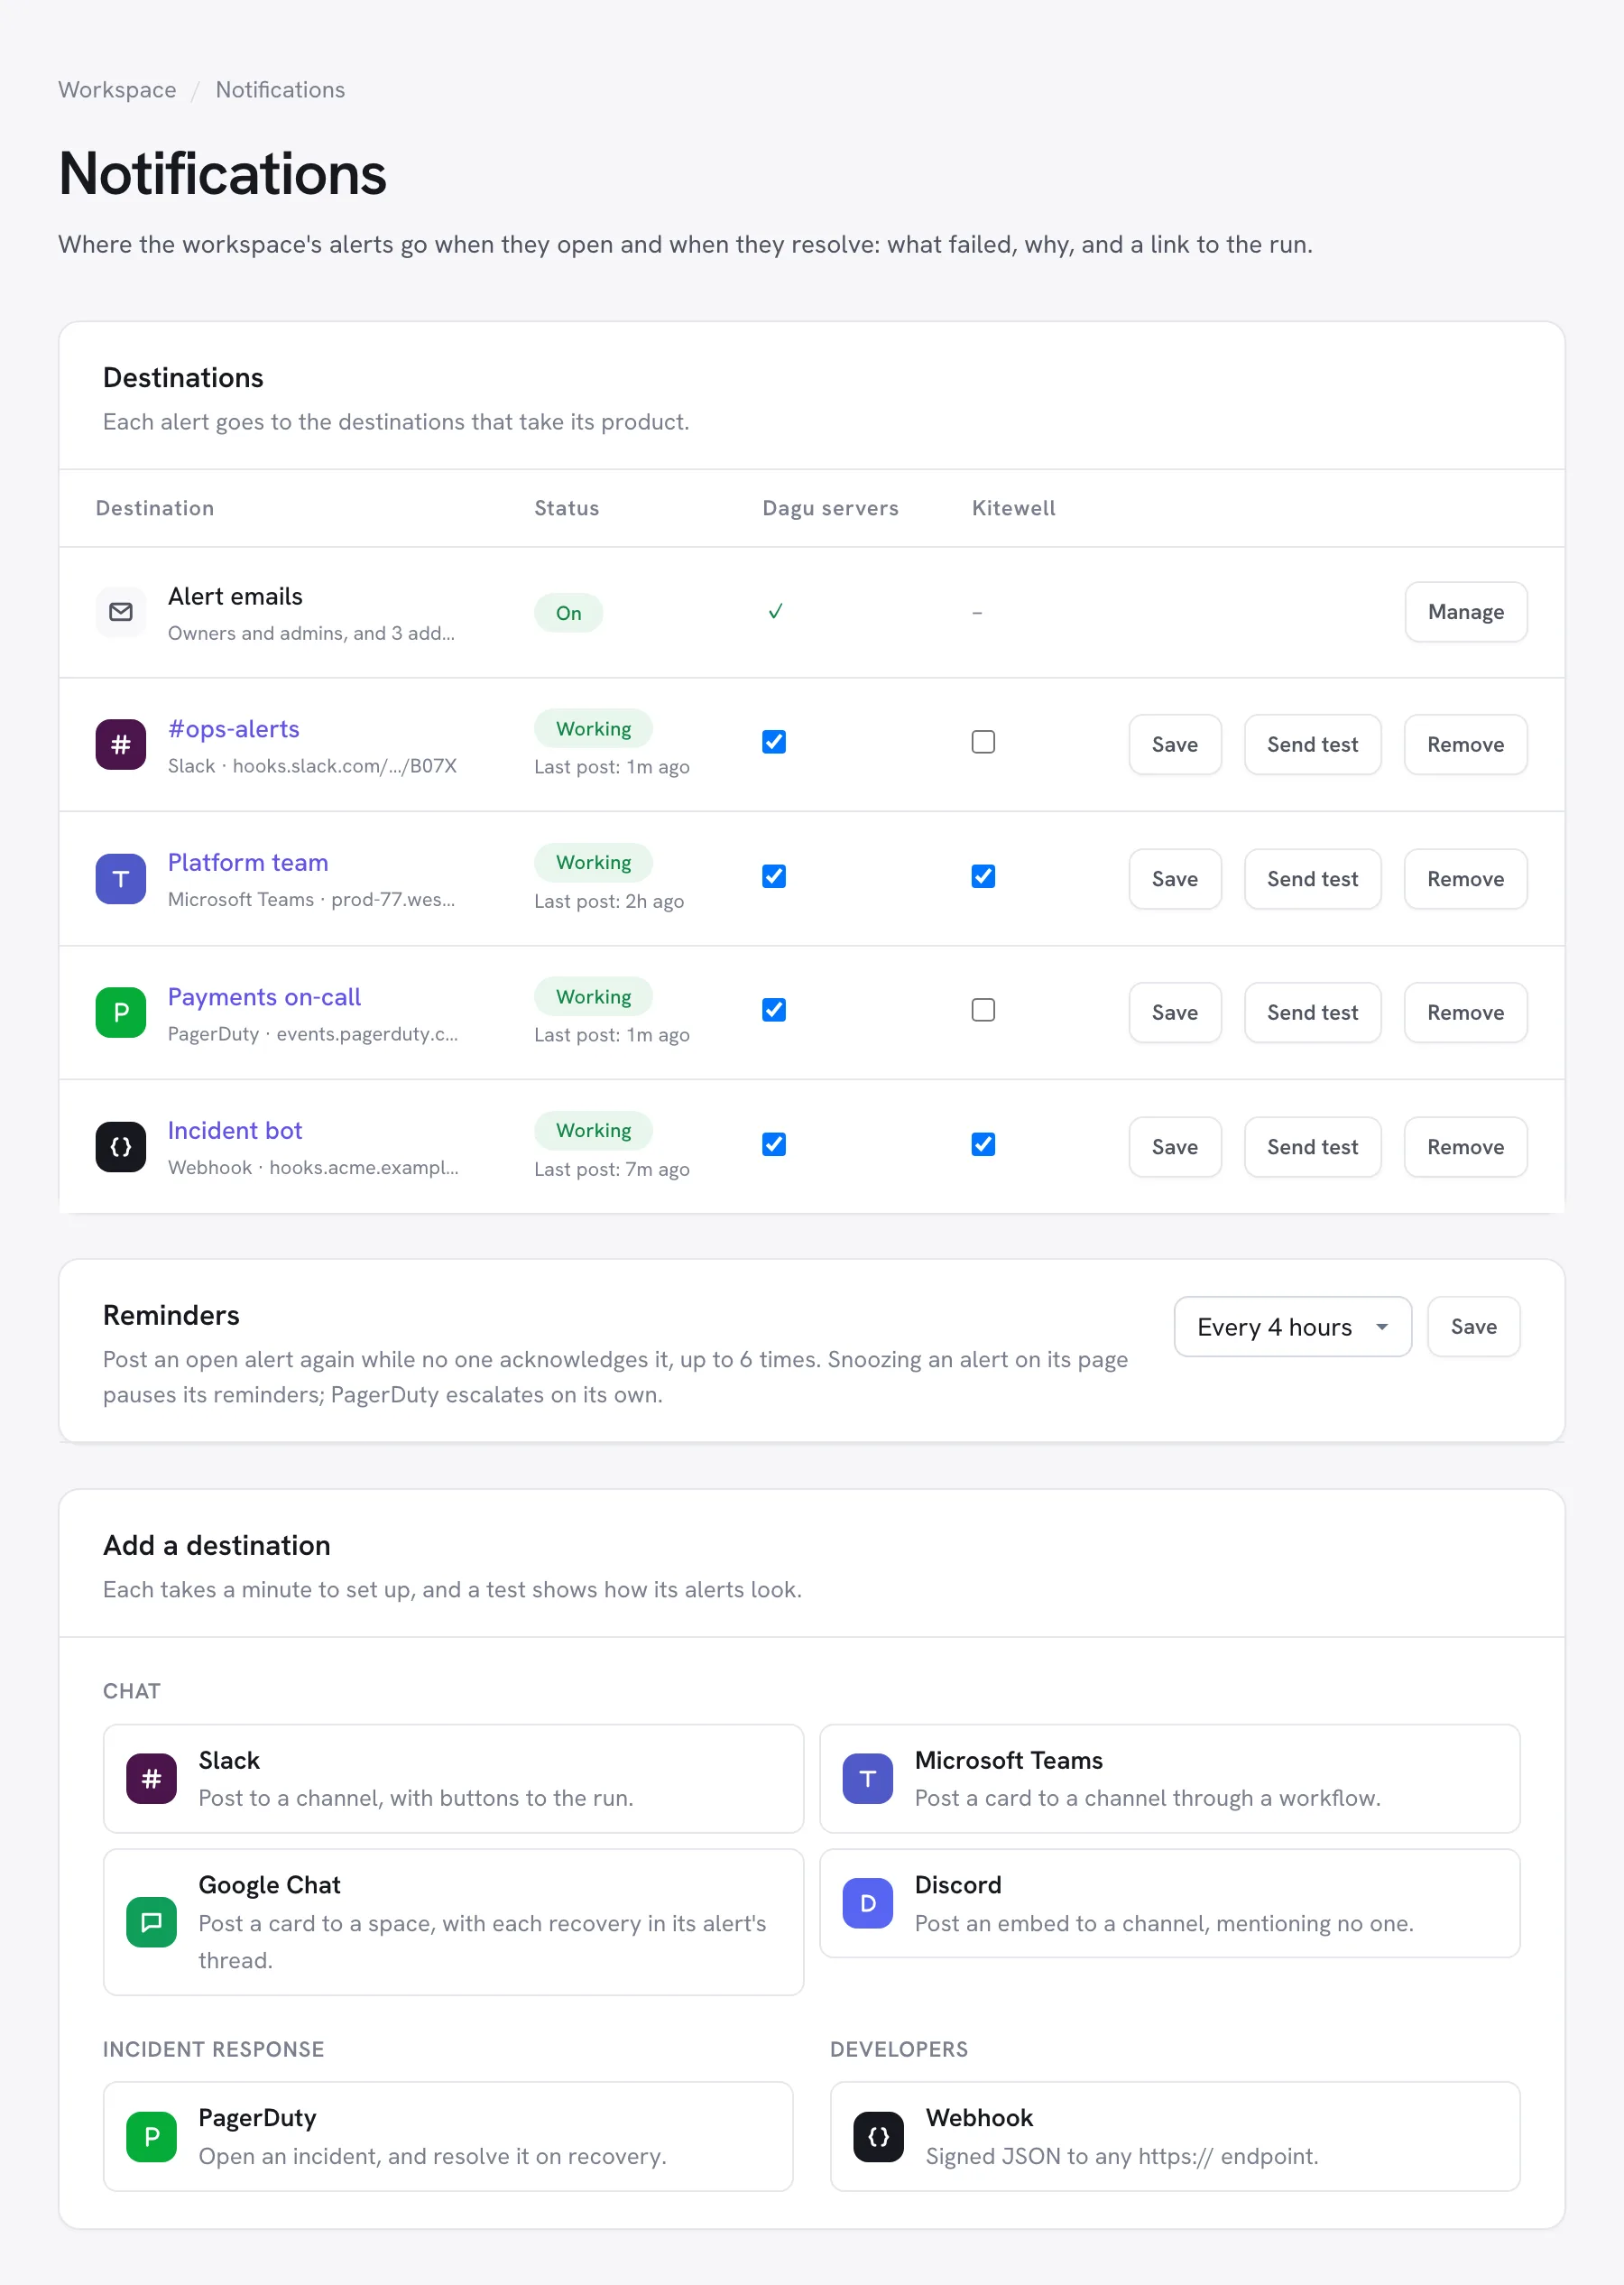
हर सोमवार workspace के time zone में 8:00 बजे, हर owner को पिछले हफ्ते का summary email मिलता है। एक link से इसे बंद करें।
आपके servers Dagu console को reports भेजते हैं। Dagu console कभी उनसे connect नहीं करता और कभी workflows नहीं चलाता।
Reports, server से console.dagu.sh को जाने वाले HTTPS requests हैं। कोई inbound port नहीं खोला जाता, और बाहर से कुछ भी server से connect नहीं होता।
अगर Dagu console तक पहुँचा न जा सके, तो workflows हमेशा की तरह चलते हैं। Server retry करता है और console वापस आते ही छूटे हुए runs भेज देता है।
Monitoring default रूप से बंद रहता है, और हर server के लिए उसका administrator इसे चुनता है। Server को connect या upgrade करने पर उसके license check-in के अलावा कुछ नहीं भेजा जाता।
Health only यह भेजता है कि server क्या चला रहा है। Health and run status उसके runs का status भी जोड़ता है, और workflow alerts के लिए ज़रूरी है। तीसरा level failed steps के error messages भी भेजता है, ताकि alerts बताएं कि run क्यों fail हुआ।
Dagu version, OS और architecture, और server process कब शुरू हुआ
चल रहे schedulers और registered coordinators की संख्या
हर finished top-level run: DAG name, run ID, attempt ID, status, trigger, और वह कब queue हुआ, शुरू हुआ और खत्म हुआ
किसी run के failed steps के नाम, 50 तक
Queued, running या waiting runs, हर report में 200 तक
Logs, outputs, parameters, environment, step commands, DAG YAML और secret values
हर report में server का license ID, server ID और heartbeat secret भी जाता है, जैसा उसके license check-in में भी होता है। DAG और step names सिर्फ run status के साथ भेजे जाते हैं; अगर आप इन्हें संवेदनशील मानते हैं तो Health only चुनें। Failed steps के error messages सिर्फ़ तीसरे level, Health, run status, and error messages, पर भेजे जाते हैं: हर error का आख़िरी हिस्सा, declared secrets को mask करके।
Dagu v2.19.1 या उसके बाद का version ज़रूरी है (free monitoring के लिए v2.19.2 या उसके बाद का), और server को HTTPS पर https://console.dagu.sh तक पहुँचना चाहिए।
Dagu में Plan & features खोलें और Connect to Dagu Console चुनें, dagu license activate चलाएँ, या server को server key के साथ start करें। Offline licenses वाले servers report नहीं भेजते।
Plan & features के Monitoring section में Turn on चुनें, फिर Health and run status या Health only चुनें। यह चुनाव restart के बिना तुरंत लागू होता है।
Code के रूप में manage किए जाने वाले servers के लिए, configuration file में level सेट करें, या DAGU_CLOUD_REPORT=runs सेट करें:
cloud:
  report: runs   # off, health, or runs
Server हर 60 सेकंड में report भेजता है, और जब कोई run fail होता है या चल रहे runs बदलते हैं, तो लगभग 5 सेकंड के भीतर। यह Dagu console में Monitoring के अंतर्गत दिखता है।
हर plan में क्या शामिल है, servers जो report करते हैं उसे Dagu Cloud कितने समय तक रखता है, और एक दिन में कितना store करता है।
हर workspace में एक server के लिए free, कम limits के साथ: हर 5 मिनट में एक report, प्रति दिन 100 stored runs, 7 दिन की run history, और owners व admins को alert emails। Team और Pro हर licensed server को cover करते हैं, 30 दिन की run history, chat, PagerDuty और webhook destinations, reminders, बहुत लंबे runs के alerts और weekly summary के साथ।
प्लान की तुलना करेंFree monitoring पिछले 7 दिनों के finished runs दिखाता है, और trial पिछले 14 दिनों के। जो server 30 दिनों तक कोई report नहीं भेजता, उसे उसके daily totals और alerts के साथ monitoring से हटा दिया जाता है।
हर workspace प्रति UTC दिन 500 finished runs तक store करता है, free monitoring पर 100 तक। Limit से ज़्यादा runs भी daily totals में गिने जाते हैं और alerts खोलते व resolve करते हैं, लेकिन उन्हें run list में नहीं जोड़ा जाता। Store करना 00:00 UTC पर फिर से शुरू होता है।
और चाहिए? हमसे संपर्क करेंSetup guide पढ़ें, या Dagu console खोलें और अपना पहला server connect करें। एक server के लिए free; Team या Pro का trial शुरू करें।