エンジニアリング
ログを見ずに Dagu サーバーをモニタリングする
セルフホストのサーバーを外からモニタリングするなら、最初に答えるべき問いがあります。何がサーバーの外に出るのか。Dagu のレポーターがそれをどう決め、障害時にも実行を失わず重複させずに送り、沈黙と故障をどう見分けるかを説明します。
TL;DR Dagu サーバーが Dagu コンソール に送るのはメタデータだけで、それもサーバーの管理者が選んだ後に限られます。サーバーは自分のイベントログをカーソルから読み、そのカーソルは Dagu コンソール が保存を確認したときにだけ進みます。そのため、障害が起きても実行を失うことも、二重に送ることもありません。Dagu コンソール はレポートが途絶えるとアラートを出しますが、途絶えた原因が自分の側にある可能性が高いときは出しません。ログ、出力、パラメーター、シークレットがサーバーの外に出ることはありません。
Dagu を自分のサーバーで動かすのには理由があります。ワークフローは、それが扱うネットワーク、認証情報、データのすぐそばにあり、動かすのにどこか別のサービスを必要としません。そうしたサーバーを見守るモニターがログを欲しがったら、サーバーをそこに置いた理由そのものを損ないます。
そのため、Dagu コンソール のモニタリングの設計は、Dagu コンソール に何を表示するかから始めませんでした。Dagu コンソール が決して見てはならないものから始め、そこから外側へ広げていきました。この記事では、主にコネクターの RFC に沿って、その判断と理由を順に説明します。
外に出ないものから決める
どのレベルでも、次のものは送りません。ログ、出力、パラメーター、環境変数、ステップのコマンド、DAG の YAML、シークレットの値、そしてエラーメッセージです。
最後のひとつは、外すのがいちばん難しいものでした。connection refused to db-02:5432 と書かれたアラートメールは、load という名前のステップが失敗したとだけ書かれたものより役に立ちます。しかし、ホスト名、ファイルパス、データの断片が紛れ込むのは、まさにエラーメッセージです。今のところは、失敗したステップの名前でどこを見ればよいかがわかり、理由はサーバーで確認します。エラーメッセージを独立した明示的な選択肢として送れるようにすべきかどうかは、RFC でもまだ未解決の問いです。推測で決めるより、開いたままにしておくほうを選びました。
何を送るかは、サーバーの管理者が選ぶレベルで決まります。
| レベル | 送るもの |
|---|---|
| オフ(デフォルト) | ライセンスのチェックインのほかには何も送らない |
| ヘルスのみ | Dagu のバージョン、OS とアーキテクチャ、プロセスの起動時刻、スケジューラーロックを持つスケジューラーの数、登録されたコーディネーターの数 |
| ヘルスと実行状況 | 加えて、完了した実行ごとに一度ずつ、その DAG 名、実行 ID、試行 ID、ステータス、トリガー、時刻と、失敗したステップの名前。さらに、キュー待ち、実行中、待機中の実行 |
このリストでいちばん多くを明かしてしまうのは DAG 名とステップ名です。そのため、これらは実行状況と一緒にしか送りません。これらを機密と考える管理者は ヘルスのみ を選べば、それでもサーバーやそのスケジューラーが止まったことはわかります。
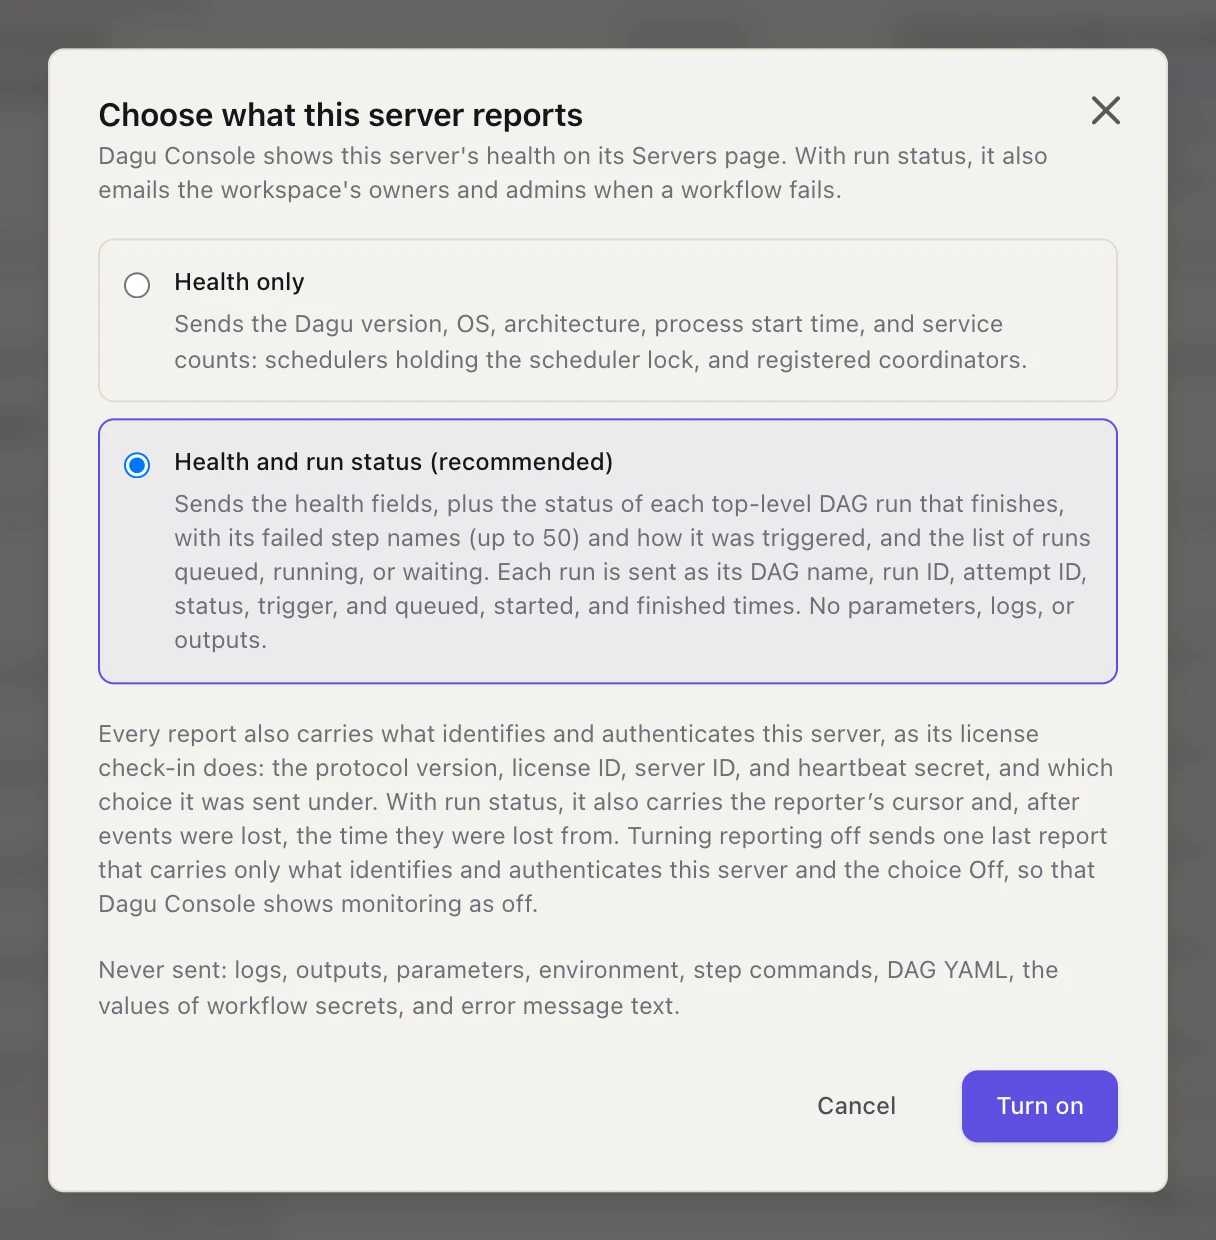
レベルのまわりには、3 つのルールがあります。
- 勝手には何も変わらない。 Dagu を更新しても、サーバーを Dagu コンソール に接続しても、新たに送られるものはありません。レベルはオフから始まります。ほかのレベルを選ぶダイアログは、何かが送られる前に、それぞれが送るものと、決して送らないものを示します。
- 決めるのはサーバー。 Dagu コンソール からレポートをオンにしたり、サーバーが送る内容を変えたりすることはできません。コードで管理するサーバーでは、設定の
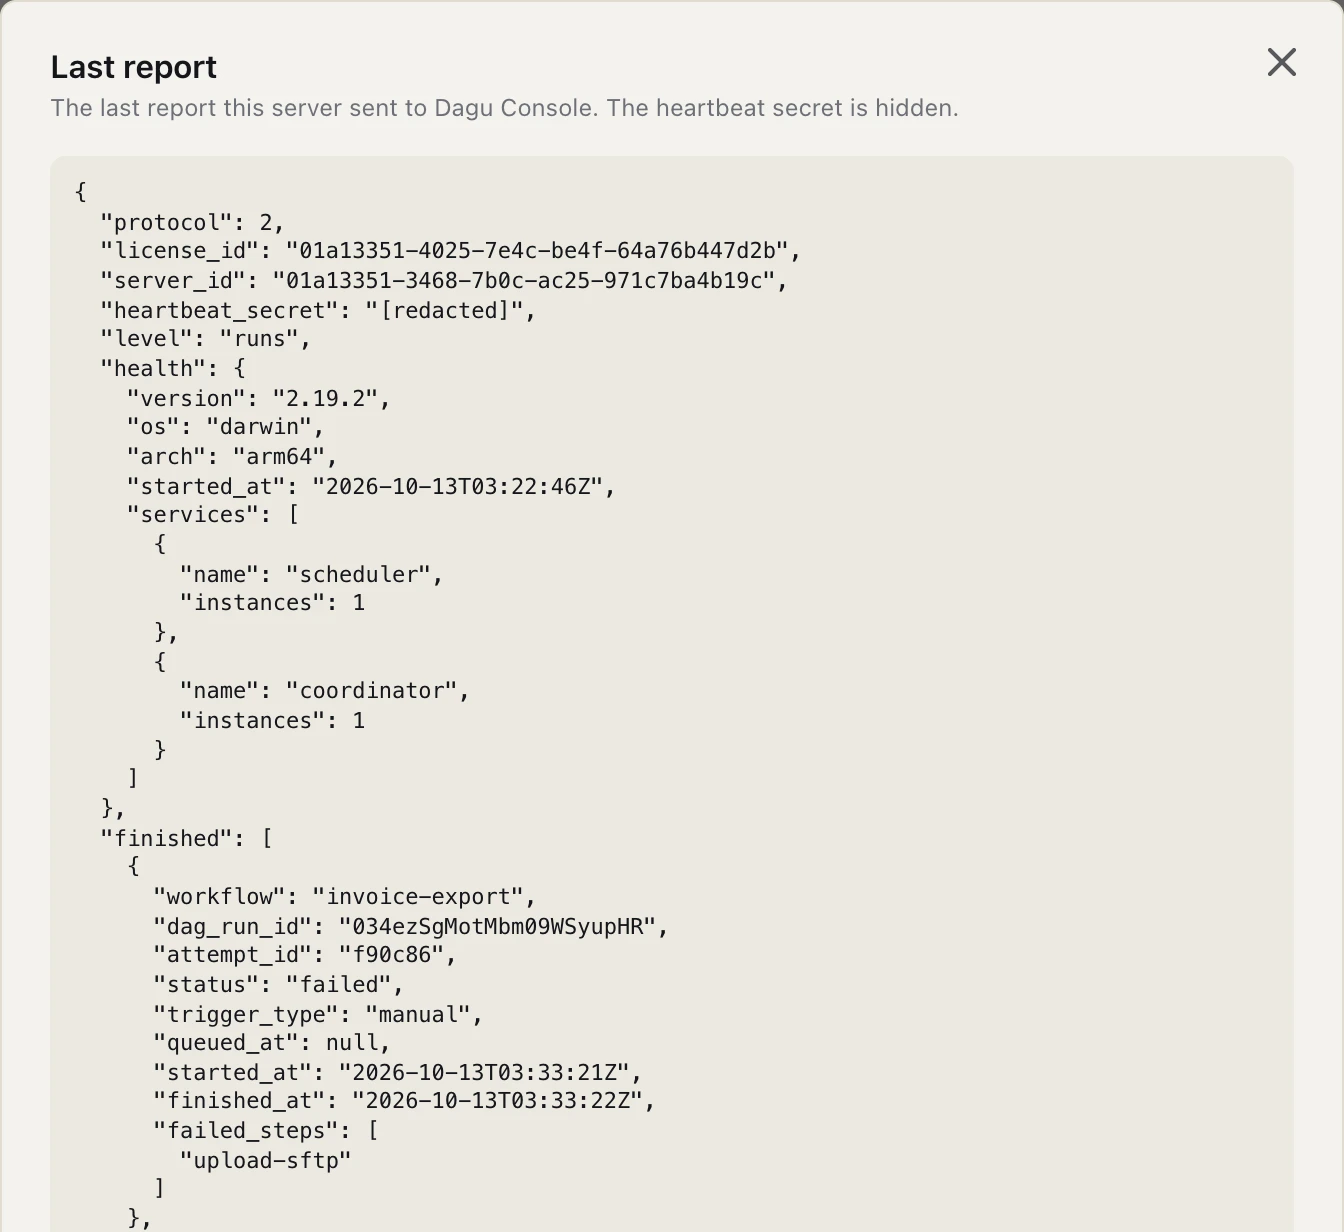
cloud.reportがレベルを固定し、Web UI はそれを読み取り専用で表示します。 - 確かめられる。 プランと機能 で、最後のレポートの JSON をそのまま確認できます。ハートビートシークレットは伏せて表示されます。
いちばん大事にしているのは、最後のルールです。確かめられないプライバシーの主張は、約束にすぎません。読めるレポートは事実です。次の画像は、ヘルスと実行状況 を選んだサーバーのレポートの冒頭です。
外向きに、ライセンスの認証情報で
サーバーは 1 回の HTTPS リクエストでレポートします。POST /api/v1/servers/report で、認証には 1 時間ごとのライセンスのチェックインと同じ認証情報を使います。サーバーへ外から接続することはありません。インストールするエージェントも、開けるインバウンドのポートも、VPN もありません。
レポートを、つなぎっぱなしの WebSocket で運ぶことも検討しました。同じ RFC で予定しているリモートアクセスは、サーバーが開く接続に乗るからです。接続を 1 本にまとめるのはすっきりしています。ただしそうすると、リモートアクセスを誰もオンにしていなくても、レポートするすべてのサーバーが、サーバー内へリクエストを運べる経路を開いたままにすることになります。データを外へ運ぶことしかできない短い POST のほうが、信頼を求める範囲が小さく済みます。
ワークフローがこれを待つことはありません。Dagu コンソール に到達できなければ、レポーターは最大 5 分まで間隔を空けながら再試行し、ワークフローはすべていつもどおりに動きます。
ネットワークが不安定でも、実行は一度ずつ
面白いのは、レポートを送ること自体ではありません。再起動、障害、データディレクトリを共有するプロセスをまたいで、完了した実行をそれぞれちょうど一度ずつ送ることです。
Dagu は、すべての実行のステータスの変化を、もともとディスク上のイベントストアに書いています。レポーターは、自分では何のコピーも持ちません。そのイベントログをカーソルから読み、カーソルより後に完了した実行を送り、Dagu コンソール の応答が送ったのと同じカーソルを確認応答したときにだけ、カーソルを進めます。
Dagu server                                   Dagu Console

event store ──▶ reporter ── POST report ────▶ stores each run once,
                   ▲     {finished…, cursor}  by server, run, attempt
                   │                                    │
                   └───────── {ack: cursor} ◀───────────┘
        saves the cursor only on this ack
Dagu コンソール が実行を保存した後、応答が届く前にリクエストがタイムアウトすると、レポーターは同じ実行をもう一度送ります。これは無害です。Dagu コンソール は完了した実行を、サーバー、実行 ID、試行 ID ごとに一度だけ保存し、ワークスペースのレポートを 1 件ずつ適用します。競合する 2 つのレポートが、同じ実行を両方とも挿入することはありません。RFC の受け入れ基準は明快です。2 時間ネットワークなしで動かした後に再接続しても、実行を 1 件も失わず、1 件も重複させないこと。
カーソルを正しく保つ工夫が 2 つあります。
- データディレクトリごとにレポーターは 1 つ。 複数の Dagu プロセスが 1 つのデータディレクトリを共有できます。プロセス間のリースによって、実行を送るのはそのうち 1 つだけになり、ヘルスはそれぞれが送ります。そのため、2 つのプロセスが同じ実行を送ることはありません。
- 欠落は推測せず、報告する。 イベントストアは、デフォルトで 1 日分のイベントを保持します。それより長く切り離されたサーバーは、その間のイベントを失っており、どんな工夫でも取り戻せません。レポーターは、自分のカーソルがストアにまだ残っているものより古いことに気づくと、最新のイベントから再開し、いつからイベントが失われたかを Dagu コンソール に伝えます。Dagu コンソール は、静かな一日に見える空白ではなく、そのサーバーに イベント欠落 と表示します。
同意は過去にも及びます。管理者が実行状況をオフにし、後で再びオンにすると、レポーターはまずカーソルを最新のイベントへ移します。実行状況のレポートを選んでも、オフだった間に完了した実行が送られることはありません。
実行中の実行
完了した実行は追記だけのログなので、カーソルが合います。実行中の実行は変化する集合なので、レポートごとに集合全体を送ります。キュー待ち、実行中、待機中の実行を、最近開始したものやキューに入ったものから最大 200 件と、その総数です。各レポートのリストが、前のリストを置き換えます。
欠落の後や、保存されたリストがないサーバーでは、レポーターはその集合を知らないため、実行履歴からバックグラウンドで組み立て直します。それまでのレポートには、リストそのものを含めません。この違いが重要です。空のリストは何も実行されていないことを意味し、リストがないことは何も意味しません。Dagu コンソール は、自信ありげなゼロを表示するくらいなら、何も表示しないほうを選びます。
Dagu コンソール は、すでに持っている実行にも同じ慎重さを当てはめます。サーバーからのレポートが止まると、そのサーバーの実行中の実行は不明と表示されます。どれも、見えないところで終わっているかもしれないからです。
毎分、必要なときはもっと早く
サーバーは 60 秒ごとにレポートし、実行が失敗、中断、拒否されたときや、実行中の実行が変わったときには、およそ 5 秒以内に前倒しでレポートします。前倒しのレポートは最短でも 5 秒間隔です。次の動画では、実際の時間の流れで、サーバー上で実行が失敗し、数秒のうちに Dagu コンソール のそのサーバーの 実行 タブに表示されます。
多くのワークフローは毎時 0 分に始まるので、レポーターはほかのすべてのサーバーと足並みがそろわないようにしています。
- Dagu の起動後の最初のレポートは、0〜60 秒のランダムな時間待ちます。
- 間隔は、それぞれ最大 10% ずれます。
- 前倒しのレポートは、きっかけとなった変化から 0〜5 秒のランダムな時間待ちます。
Dagu コンソール は、いつでも頻度を下げるよう求められます。各応答は次にいつレポートするかを伝え、早すぎるレポートには Retry-After 付きの 429 を返します。レポーターはどちらにも従い、カーソルを保持するので、速度を落としても実行が遅れるだけで、失われることはありません。レポートが制限、拒否、または失敗すると、受け入れられるまで前倒しのレポートは送りません。苦しんでいる Dagu コンソール に、さらにトラフィックを浴びせないためです。無料枠のサーバーには 5 分ごとにレポートするよう伝え、前倒しのレポートは最短 30 秒間隔でしか受け付けません。仕組みは同じです。
沈黙と故障を見分ける
レポートを止めたサーバーは、エラーを出しません。モニタリングが存在するのはまさにこのケースのためで、同時にいちばん間違えやすいケースでもあります。
毎分、スケジュールされたティックが、静かになったサーバーを探します。データベースのリースにより、Dagu コンソール のインスタンスがいくつあっても、ティックは一度に 1 つしか動きません。10 分間、または低い頻度でレポートするよう伝えたサーバーならレポート間隔の 5 倍の間、静かなままのサーバーには、レポート停止のアラートを開き、受信者にメールを送ります。次のレポートでアラートは閉じ、そのメールには静かだった時間が書かれます。
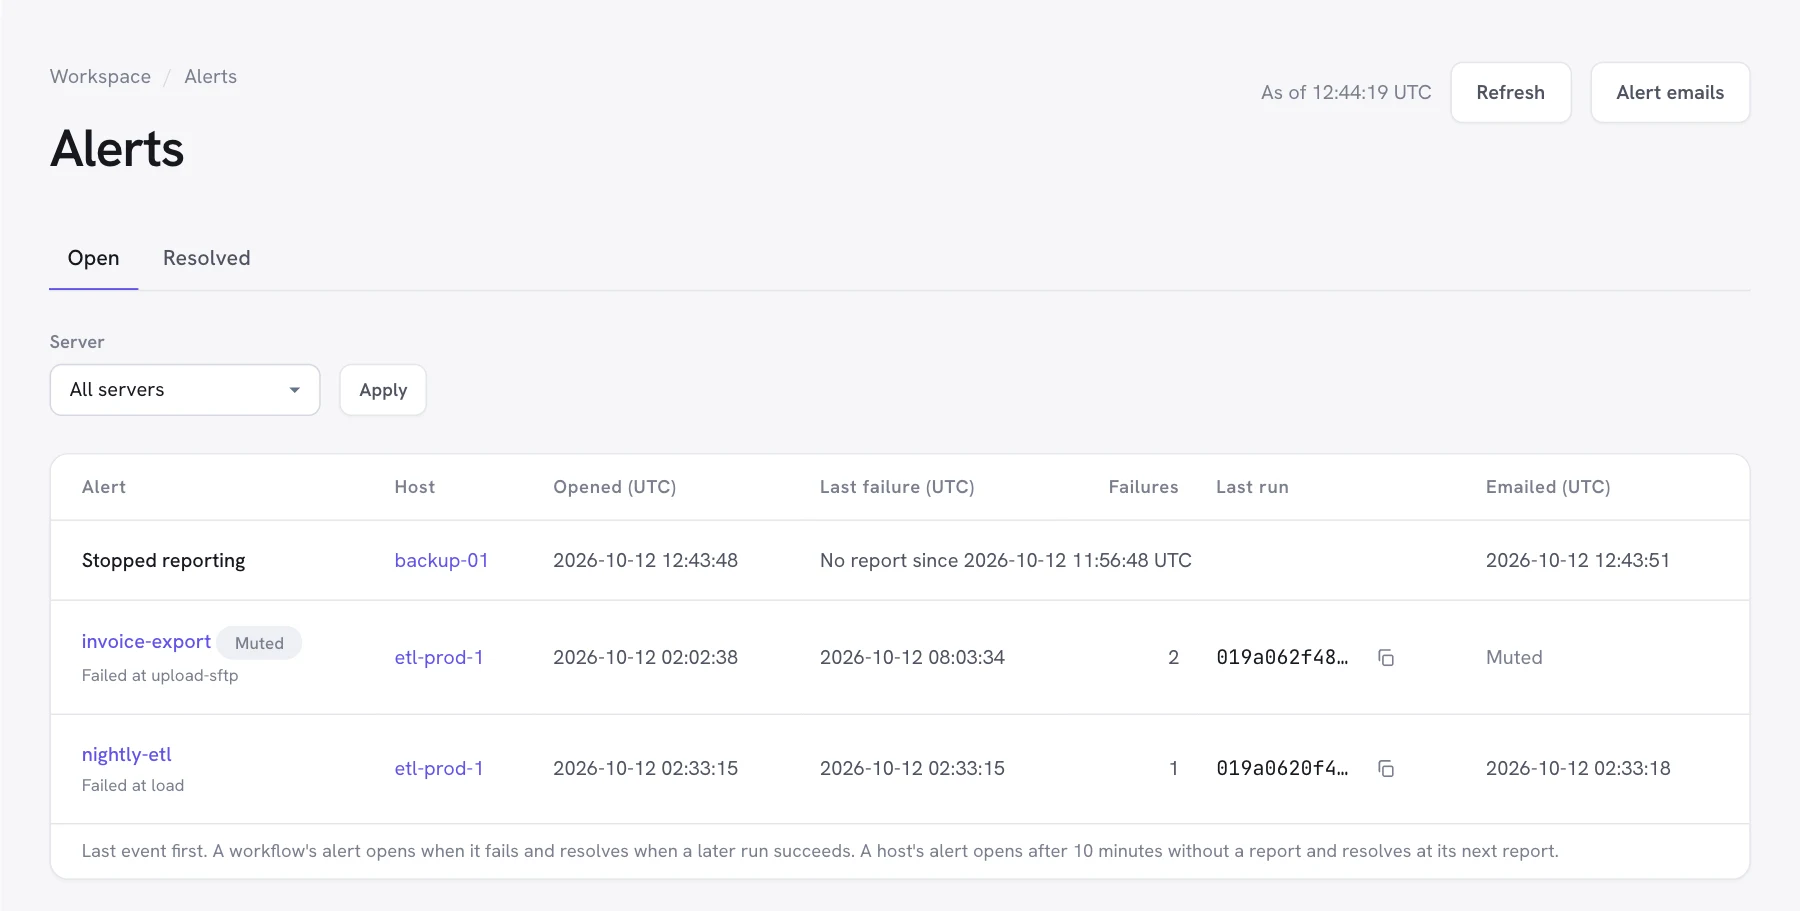
手間の大半は、オオカミ少年にならないことに費やしています。
- モニタリングをオフにするのは障害ではない。 管理者がレポートをオフにすると、サーバーはそのことを伝える最後のレポートを 1 回送ります。中身は自分の識別情報だけです。Dagu コンソール は モニタリングオフ と表示し、アラートは開きません。
- Dagu コンソール の沈黙は、サーバーの沈黙ではない。 同じティックで 10 台以上のサーバーが静かになり、それが監視しているサーバーの 30% 以上であれば、すべてが同時に故障したと考えるより、Dagu コンソール がそれらを見失った可能性のほうがはるかに高くなります。ティックはそれをログに残し、アラートは開きません。いちばん避けたかったのは、こちら側の問題について、すべての顧客に一斉にメールを送ってしまうことでした。
- Dagu コンソール が見ていなかった時間は数えない。 ティック自体が 3 分を超えて止まっていた場合、沈黙は再開後の最初のティックから数えます。
- いなくなったサーバーは、沈黙とは違う。 30 時間レポートしていないサーバーは監視の対象から外れるので、ずっと前に退役したサーバーがアラートを開くことはありません。
ワークフローの失敗も同じように扱います。失敗した実行はそのワークフローのアラートを 1 件開き、その後の失敗は新しいアラートを開かずにそのアラートに加わり、後の実行が成功するとアラートは解決します。同時に開いたり解決したりしたアラートは、1 通のメールにまとめて届きます。
実行を残さずに傾向を出す
完了した実行は 14 日間、UTC の 1 日ごとに 1 つのデータベースパーティションに保存します。そのため、1 日分を期限切れにするのは、行の削除ではなくテーブルの削除で済みます。一方で、インサイトは最大 90 日を対象にし、その元になる日次の集計は 13 か月保存します。p95 を計算するための実行は残っていません。
各ワークフローは、UTC の 1 日ごとに、成功した実行と失敗した実行の数、最も長い実行、16 個の所要時間バケットそれぞれに入った実行の数を保持します。バケットの下限は、0、1、2、5、10、30 秒、1、2、5、10、20、30 分、1、2、4、8 時間です。30 日間の p95 は、これらのバケットを合計し、95 パーセンタイルを含むバケットを見つけ、その中で補間して求めます。境界が比率で増えていくので、補間は幾何的に行います。推定値が、実際に観測された最長の実行を超えることはありません。Dagu コンソール はこれに ≈ を付けて表示します。推定値だからです。
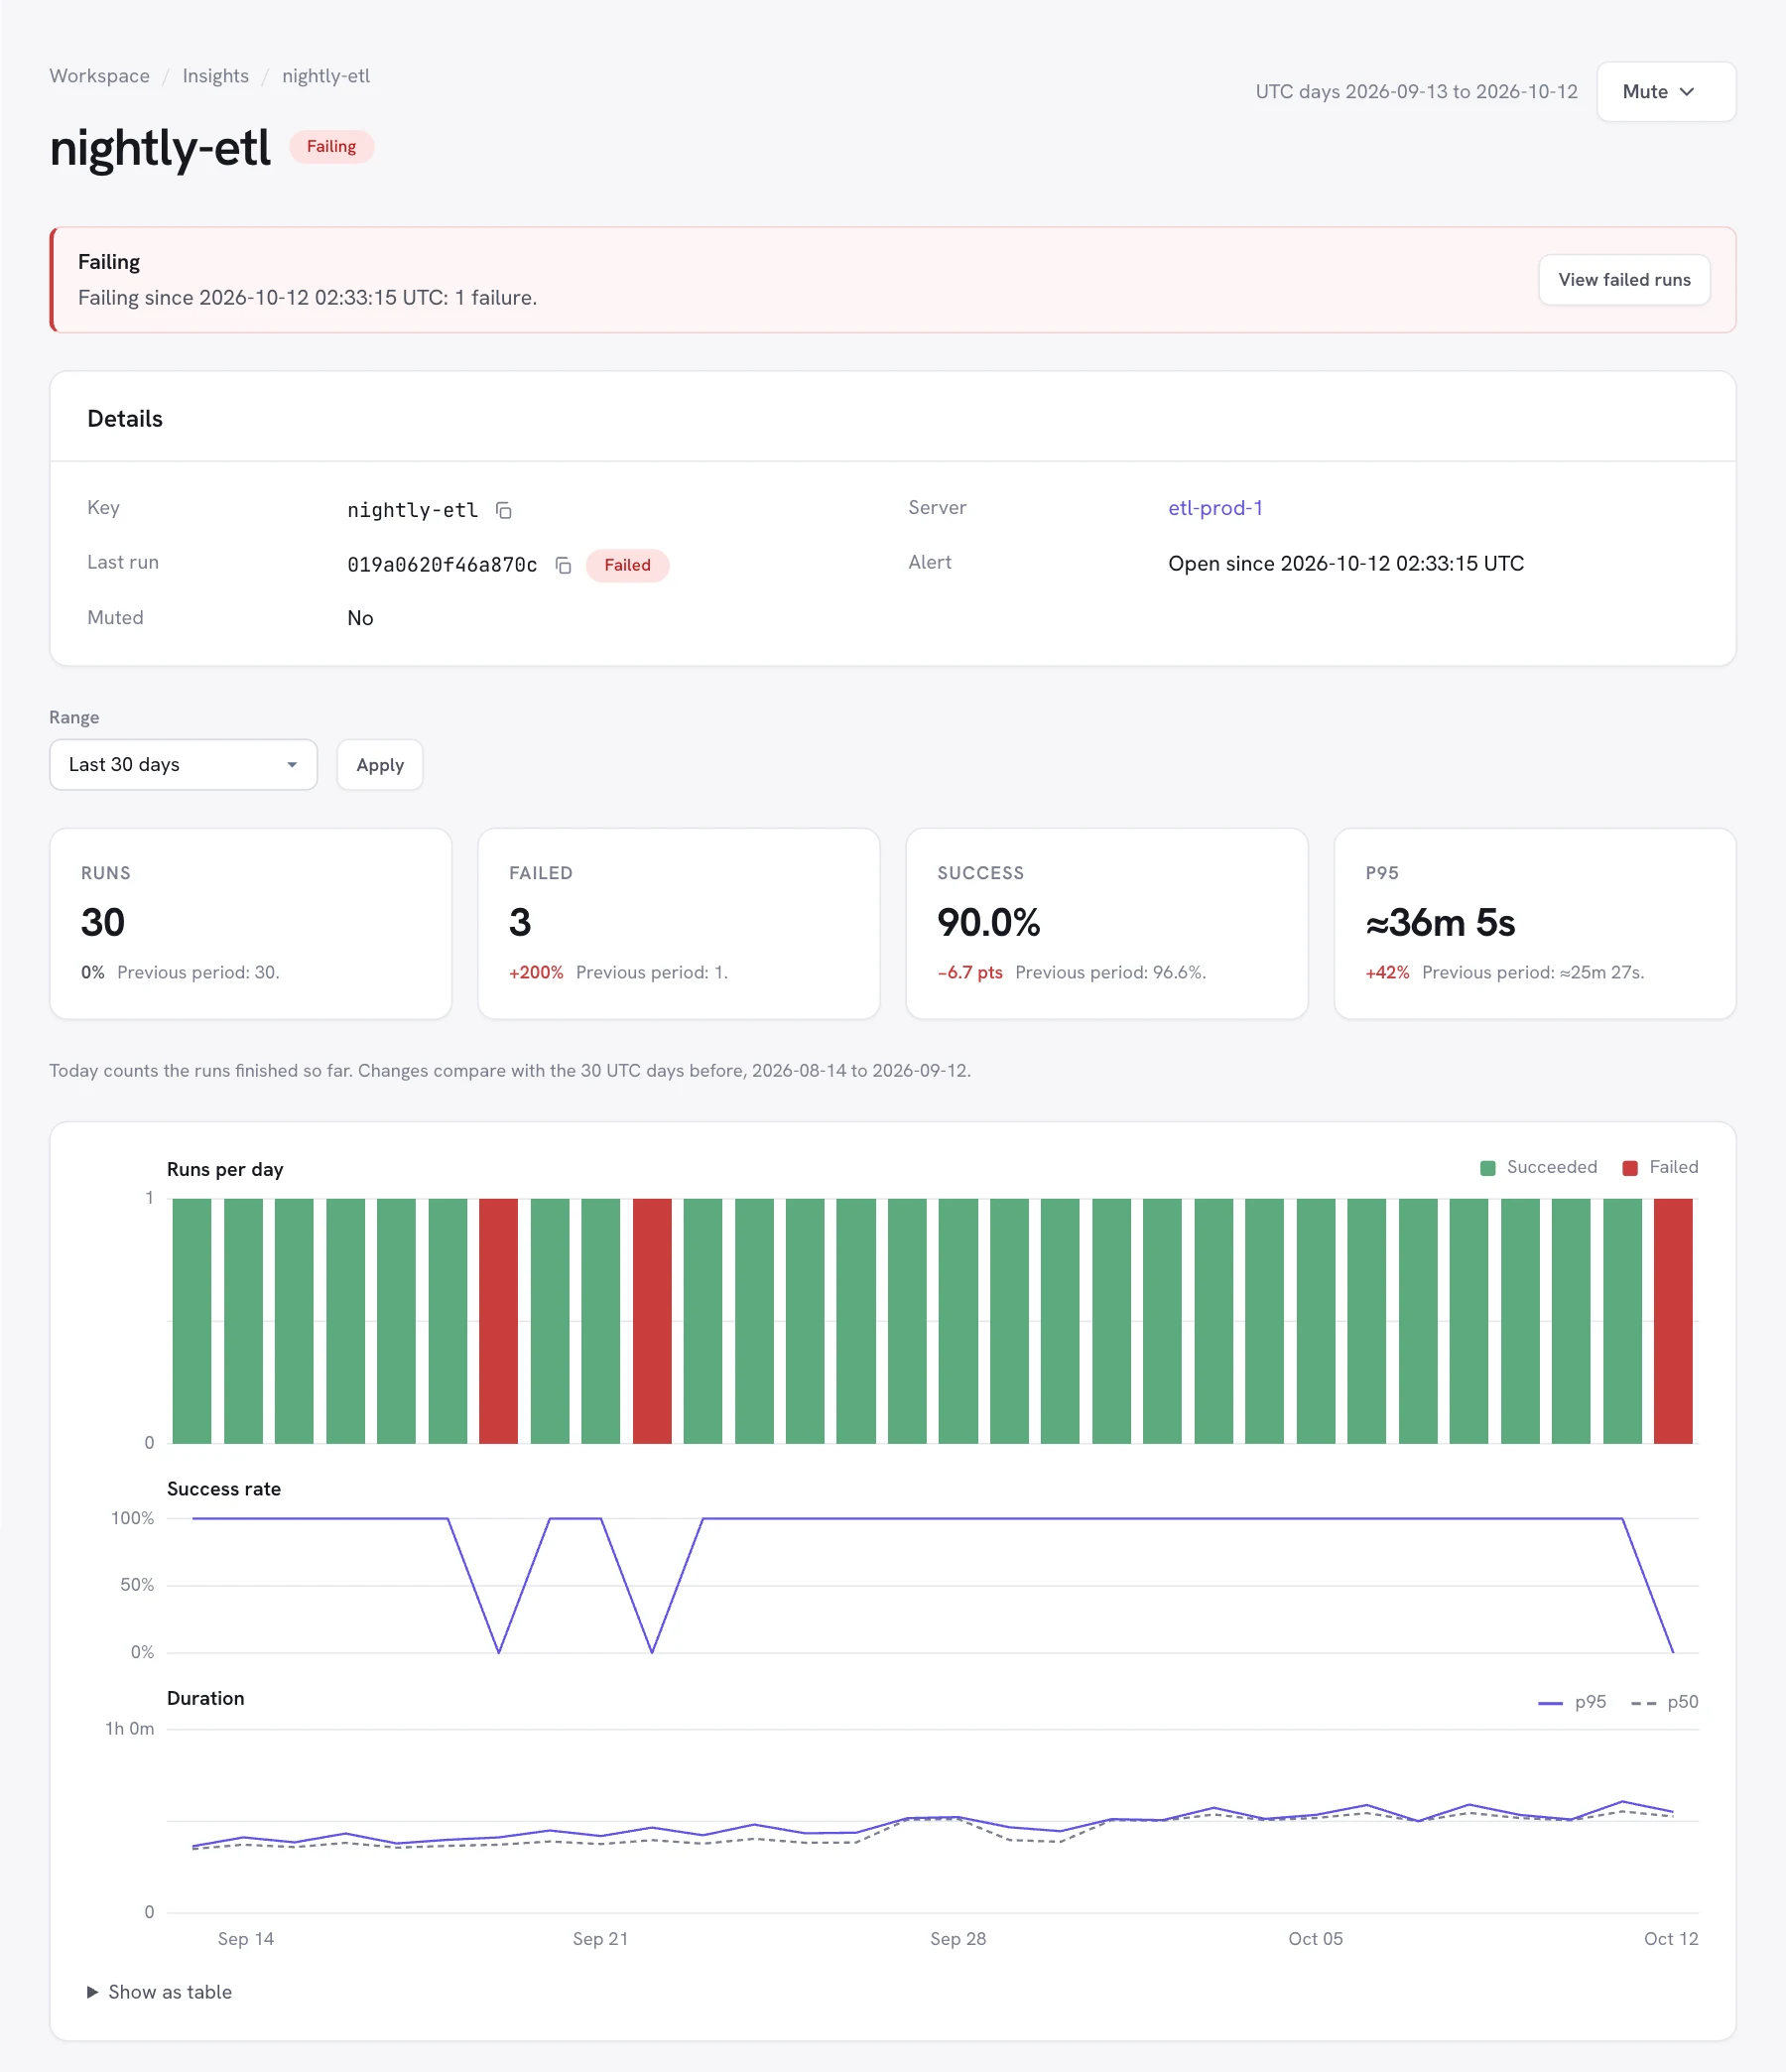
バケットは決して変えられません。ある境界の組で数えた日は、別の組では別の意味になってしまうからです。
トレードオフ
レポートは誰かがオンにするまでオフなので、デフォルトでオンの場合より、レポートするサーバーは少なくなります。これは意図したトレードオフです。レポートするサーバーはどれも、管理者が選んだものだけを送り、管理者はそれが何だったかを正確に読めます。
モニタリングのドキュメントには、レポートに含まれるものがフィールドごとにすべて載っており、RFC には通信の契約の全体があります。どちらも公開しているのは、最後のレポートがサーバー上でワンクリックで見られるのと同じ理由です。ログが手元にとどまるという主張は、信じて受け取るものではなく、確かめられるものであるべきです。
Written by
Daguプロジェクトのコントリビューター。
More from Yota Hamada